LeetCode1.md
May 5, 2021 · View on GitHub
LeetCode 热门100题-题解(下)
主要是记录自己刷题的过程,也方便自己复习
第155题-最小栈
第160题-相交链表
第142题-环形链表II
第739题-每日温度
第347题-前K个高频元素
第49题-字母异位词分组
第32题-最长有效括号
第543题-二叉树的直径
第79题-单词搜索
第96题-不同的二叉搜索树
第239题-滑动窗口最大值
第146题-LRU缓存机制
第236题-二叉树的最近公共祖先
第114题-二叉树展开为链表
第84题-柱状图中最大的矩形
第148题-排序链表
第617题-合并二叉树
第287题-寻找重复数
第152题-乘积最大子数组
第72题-编辑距离
第139题-单词拆分
第76题-最小覆盖子串
第124题-二叉树中的最大路径和
第461题-汉明距离
第128题-最长连续序列
第647题-回文子串
第337题-打家劫舍III
第238题-除自身以外数组的乘积
第207题-课程表
第309题-最佳买卖股票时机含冷冻期
第416题-分割等和子集
第560题-和为K的子数组
第448题-找到所有数组中消失的数字
第437题-路径总和III
第338题-比特位计数
第406题-根据身高重建队列
第538题-把二叉搜索树转换为累加树
第297题-二叉树的序列化与反序列化
第438题-找到字符串中所有字母异位词
第240题-搜索二维矩阵II
第494题-目标和
第621题-任务调度器
第581题-最短无序连续子数组
第155题-最小栈
设计一个支持 push ,pop ,top 操作,并能在常数时间内检索到最小元素的栈。
push(x) —— 将元素 x 推入栈中。 pop() —— 删除栈顶的元素。 top() —— 获取栈顶元素。 getMin() —— 检索栈中的最小元素。
示例:
输入: ["MinStack","push","push","push","getMin","pop","top","getMin"] [[],[-2],[0],[-3],[],[],[],[]]
输出: [null,null,null,null,-3,null,0,-2]
解释: MinStack minStack = new MinStack(); minStack.push(-2); minStack.push(0); minStack.push(-3); minStack.getMin(); --> 返回 -3. minStack.pop(); minStack.top(); --> 返回 0. minStack.getMin(); --> 返回 -2.
解题思路
就是用一个最小栈来记录最小值
Stack<Integer> stack;
    Stack<Integer> minStack;
    /** initialize your data structure here. */
    public MinStack() {
        stack = new Stack<Integer>();
        minStack = new Stack<Integer>();
    }

    public void push(int x) {
        if(minStack.size()==0||x<=minStack.peek()) {
            minStack.push(x);
        }
        stack.push(x);
    }

    public void pop() {
        if(stack.peek().equals(minStack.peek())) {
            minStack.pop();
        }
        stack.pop();
    }

    public int top() {
        return stack.peek();
    }

    public int getMin() {
       return minStack.peek();
    }
第160题-相交链表
编写一个程序,找到两个单链表相交的起始节点。
如下面的两个链表**:**
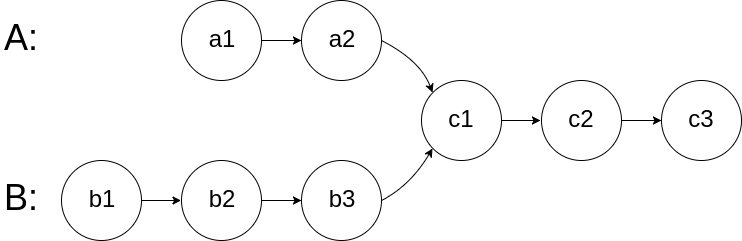
在节点 c1 开始相交。
解题思路
分别计算出链表A,链表B的长度,让长的链表先走n步,直到两个链表剩余节点长度一样,然后每个链表都走一步,直到节点相等,即为相交节点。
public ListNode getIntersectionNode(ListNode headA, ListNode headB) {
        int lengthA=0;
        ListNode nodeA = headA;
        while(nodeA!=null) {
            lengthA++;
            nodeA=nodeA.next;
        }
        int lengthB=0;
        ListNode nodeB = headB;
        while(nodeB!=null) {
            lengthB++;
            nodeB=nodeB.next;
        }
        nodeA = headA;
        nodeB = headB;
        while(lengthA!=lengthB) {
            if (lengthA>lengthB) {
                lengthA--;
                nodeA = nodeA.next;
            } else {
                lengthB--;
                nodeB = nodeB.next;
            }
        }
        while(nodeA!=null && nodeB!=null) {
            if(nodeA == nodeB) {
                return nodeA;
            }
            nodeA = nodeA.next;
            nodeB = nodeB.next;
        }
        return null;
    }
第142题-环形链表II
给定一个链表,返回链表开始入环的第一个节点。 如果链表无环,则返回 null。
为了表示给定链表中的环,我们使用整数 pos 来表示链表尾连接到链表中的位置(索引从 0 开始)。 如果 pos 是 -1,则在该链表中没有环。注意,pos 仅仅是用于标识环的情况,并不会作为参数传递到函数中。
说明:不允许修改给定的链表。
进阶:
你是否可以使用 O(1) 空间解决此题?
示例 1:

输入:head = [3,2,0,-4], pos = 1 输出:返回索引为 1 的链表节点 解释:链表中有一个环,其尾部连接到第二个节点。
解题思路
public ListNode detectCycle(ListNode head) {
        //快慢节点在圆中相遇
        //然后慢节点在圆中走一圈,计算出圆的周长
        //快节点凑头
        if (head==null || head.next == null) {
            return null;
        }
        ListNode slow = head.next;
        ListNode quick = head.next.next;
  			//通过快慢指针,让两个指针在环中相遇
        while (quick!=slow) {
            if (quick == slow && quick!=null) {
                break;
            }
            slow = slow.next;
            if (quick==null||quick.next == null) {
                return null;
            }
            quick = quick.next;
            quick = quick.next;
        }
    		//计算环的长度
        int circleLength = 1;
        ListNode copySlow = slow.next;
        while (copySlow != slow) {
            copySlow = copySlow.next;
            circleLength++;
        }
				//快指针先走环的长度步
        quick = head;
        while (circleLength>0) {
            quick = quick.next;
            circleLength--;
        }
        slow = head;
  			//慢指针出发,相遇的节点就是环的入口
        while (quick!=slow) {
            quick = quick.next;
            slow = slow.next;
        }
        return quick;
    }
第739题-每日温度
请根据每日 气温 列表,重新生成一个列表。对应位置的输出为:要想观测到更高的气温,至少需要等待的天数。如果气温在这之后都不会升高,请在该位置用 0 来代替。
例如,给定一个列表 temperatures = [73, 74, 75, 71, 69, 72, 76, 73],你的输出应该是 [1, 1, 4, 2, 1, 1, 0, 0]。
提示:气温 列表长度的范围是 [1, 30000]。每个气温的值的均为华氏度,都是在 [30, 100] 范围内的整数。
解题思路
其实跟滑动窗口最大值那个题的解题思路很像,就是维护一个还没有排序好的栈,每次把栈中比当前遍历元素小的,都出栈,然后计算等待天数,然后将当前元素入栈。
   public int[] dailyTemperatures(int[] T) {
        if (T == null || T.length==0) {
            return null;
        }
        int[] result = new int[T.length];
        Stack<Integer> stack = new Stack<>();
        stack.add(0);
        for (int i = 1; i < T.length; i++) {
            //比栈顶元素小,栈
            if (stack.size() == 0 || T[i] <= T[stack.peek()]) {
                stack.push(i);
            } else {
               // 比栈顶元素大,就一直出栈
                while (stack.size() >0 && T[i] > T[stack.peek()]) {
                    int index = stack.pop();
                    result[index] = i - index;
                }
                stack.push(i);
            }
        }
        return result;
    }
第347题-前K个高频元素
给定一个非空的整数数组,返回其中出现频率前 k 高的元素。
示例 1:
输入: nums = [1,1,1,2,2,3], k = 2 输出: [1,2] 示例 2:
输入: nums = [1], k = 1 输出: [1]
解题思路
先使用一个HashMap来统计各元素的频率,然后取前k个元素建立小顶堆,然后对后面的元素进行遍历,如果频率高于堆顶元素,就与堆顶元素交换,然后对堆进行调整。
public int[] topKFrequent(int[] nums, int k) {
        HashMap<Integer,Integer> map = new HashMap<Integer,Integer>();
        for(int i = 0;i<nums.length;i++) {
            Integer value = map.get(nums[i]);
            value = value == null ? 1 : value+1;
            map.put(nums[i],value);
        }
        Object[] array =  map.keySet().toArray();
        //进行堆排
        int[] result = new int[k];
        for (int i = 0; i < k; i++) {
            result[i] = (Integer)array[i];
        }
        //建立小顶堆
        for (int i = result.length/2-1; i >= 0; i--) {
            adjustHeap(result,i,result.length,map);
        }
        for (int i = k; i < array.length ; i++) {
            Integer key = (Integer) array[i];
            if (map.get(key) >= map.get(result[0])) {
                result[0] = (Integer)array[i];
                adjustHeap(result,0,result.length,map);
            }
        }
        return result;
    }
    void adjustHeap(int[] array, int i,int length,HashMap<Integer,Integer> map) {
        while (2*i+1<length) {//左节点存在
            int left = 2*i+1;
            int right = 2*i+2;

            int min = map.get(array[i]) < map.get(array[left]) ? i : left;
            if (right<length && map.get(array[right]) < map.get(array[min])) {//右节点存在,并且还比最大值大
                min = right;
            }
            if (min == i) {//当前已经是最小值
                break;
            } else {//左节点或者右节点是最小值,那么就将当前节点与最小的节点交换
                swap(array,i,min);
                i = min;
            }
        }
    }
    void swap(int[] array, int a,int b) {
        int temp = array[a];
        array[a] = array[b];
        array[b] = temp;
    }
第49题-字母异位词分组
给定一个字符串数组,将字母异位词组合在一起。字母异位词指字母相同,但排列不同的字符串。
示例:
输入: ["eat", "tea", "tan", "ate", "nat", "bat"] 输出: [ ["ate","eat","tea"], ["nat","tan"], ["bat"] ] 说明:
所有输入均为小写字母。 不考虑答案输出的顺序。
解题思路
就是对字符串进行遍历,取出每个字符串,计算它对应的字典序最小的字符串(例如:"ate","eat","tea",他们字典序最小的字符串是"aet"),然后判断map中是否存在,不存在就创建一个List,将字符串添加进去,存在就在原List中添加该字符串。
  public List<List<String>> groupAnagrams(String[] strs) {
        HashMap<String,List> map = new HashMap<String,List>();
        for (String str : strs) {
            char[] charArray = str.toCharArray();
            Arrays.sort(charArray);
            String sortedString = new String(charArray);
            List strList = map.get(sortedString);
            if (strList == null) {
                strList = new LinkedList();
            }
            strList.add(str);
            map.put(sortedString,strList);
        }
        ArrayList totalList = new ArrayList<>();
        totalList.addAll(map.values());
        return totalList;
    }
第32题-最长有效括号
给定一个只包含 '(' 和 ')' 的字符串,找出最长的包含有效括号的子串的长度。
示例 1:
输入: "(()" 输出: 2 解释: 最长有效括号子串为 "()" 示例 2:
输入: ")()())" 输出: 4 解释: 最长有效括号子串为 "()()"
解题思路
判断一个字符是否在是有效括号,就是对字符串遍历,如果是(,就将(字符入栈,如果是)字符,就判断栈是否为有元素,有元素代表括号匹配上了,将当前括号和栈顶元素括号都标记为有效括号。标记的方式是将recordArray数组中相应下标置为1,然后统计最长有效括号就是统计recordArray数组中连续1的个数。
		public int longestValidParentheses(String s) {
        Stack<Integer> stack = new Stack();

        int[] recordArray = new int[s.length()];
        for (int i = 0; i < s.length(); i++) {
            char c = s.charAt(i);
            if (c=='(') {
                stack.push(i);
            } else if (c==')' && stack.size()>0) {
                //说明这个位置可以匹配
                recordArray[i]=1;
                int leftIndex = stack.pop();
                recordArray[leftIndex] = 1;
            }
        }
        //统计recordArray张连续1的长度
        int max = 0;
        int currentSize =0;
        for (int i = 0; i < recordArray.length; i++) {
            if (recordArray[i] ==0) {
                currentSize=0;
            } else if (recordArray[i] ==1) {
                currentSize++;
            }
            max = max > currentSize ? max : currentSize;
        }
        return max;
    }
第543题-二叉树的直径
给定一棵二叉树,你需要计算它的直径长度。一棵二叉树的直径长度是任意两个结点路径长度中的最大值。这条路径可能穿过也可能不穿过根结点。
示例 : 给定二叉树
      1
     / \
    2   3
   / \
  4   5
返回 3, 它的长度是路径 [4,2,1,3] 或者 [5,2,1,3]。
解题思路
其实根节点的直径就是左节点深度+右节点深度,其他节点也是这个公示,所以可以递归求解出左右节点的深度,然后计算当前节点的直径,然后与左右节点的直径进行判断,返回最大值。
int maxDiameter = 0;
public int diameterOfBinaryTree(TreeNode root) {
      if (root==null){return 0;}
      maxDepth(root);
      return maxDiameter;
}

public int maxDepth(TreeNode root) {
      if (root==null) {return 0;}
      int leftDepth = maxDepth(root.left);
      int rightDepth = maxDepth(root.right);
      int diameter = leftDepth + rightDepth;
      maxDiameter = diameter > maxDiameter ? diameter : maxDiameter;
      return leftDepth>rightDepth?leftDepth+1 : rightDepth+1;
}
第79题-单词搜索
给定一个二维网格和一个单词,找出该单词是否存在于网格中。
单词必须按照字母顺序,通过相邻的单元格内的字母构成,其中“相邻”单元格是那些水平相邻或垂直相邻的单元格。同一个单元格内的字母不允许被重复使用。
示例:
board = [ ['A','B','C','E'], ['S','F','C','S'], ['A','D','E','E'] ]
给定 word = "ABCCED", 返回 true 给定 word = "SEE", 返回 true 给定 word = "ABCB", 返回 false
解题思路
就是遍历数组,判断每个字符与字符串首字符是否相同,相同的话就继续判断周围的字符是否满足要求。需要注意的时,在判断时会把走过的路径添加到HashSet中去,防止一个位置的字符重复被使用。
HashSet<String> set = new HashSet<>();
    public boolean exist(char[][] board, String word) {
        if (board==null||board[0]==null||word==null||word.length()==0) {
            return false;
        }
        char firstChar = word.charAt(0);
        for (int i = 0; i < board.length; i++) {
            for (int j = 0; j < board[0].length; j++) {
                set = new HashSet<>();
                if(board[i][j] == firstChar
                        && judgeTheChar(board, word,1,i,j) == true) {
                    return true;
                }
            }
        }
        return false;
    }

    boolean judgeTheChar(char[][] board,String word,int index,int i,int j) {

        String key = i + "-" + j;
        if (set.contains(key)) {
            return false;
        } else {
            set.add(key);
        }
        if (index>= word.length()) {
            return true;
        }
        char currentChar = word.charAt(index);
        //上
        if (i-1>=0 &&
                board[i-1][j] == currentChar && judgeTheChar(board, word,index+1,i-1,j) == true) {
            return true;
        }
        //下
        if (i+1<board.length &&
                board[i+1][j] == currentChar
                && judgeTheChar(board, word,index+1,i+1,j) == true) {
            return true;
        }
        //左
        if (j-1>=0 &&
                board[i][j-1] == currentChar
                && judgeTheChar(board, word,index+1,i,j-1) == true) {
            return true;
        }

        if (j+1< board[0].length &&
                board[i][j+1] == currentChar
                && judgeTheChar(board, word,index+1,i,j+1) == true) {
            return true;
        }
        return false;
    }
第96题-不同的二叉搜索树
给定一个整数 n,求以 1 ... n 为节点组成的二叉搜索树有多少种?
示例:
输入: 3 输出: 5 解释: 给定 n = 3, 一共有 5 种不同结构的二叉搜索树:
1 3 3 2 1
\ / / / \
3 2 1 1 3 2
/ / \
2 1 2 3
解题思路
就是把一个二叉搜索树的组合种数,其实是左子树的组合数乘以右子树的组合数,假设n为4,f(n)代表组合种数,二叉树共有四个节点,那么二叉树肯定有根节点,组合主要分为以下几类: 1.左子树有0个节点,右子树有3个节点,f(0)*f(3) 2.左子树有1个节点,右子树有2个节点,f(1)*f(2) 3.左子树有2个节点,右子树有1个节点,f(2)*f(1) 4.左子树有3个节点,右子树有0个节点,f(3)*f(0) 所以,f(4)=f(0)*f(3)+f(1)*f(2)+f(2)*f(1)+f(3)*f(0)
而f(0)=1,f(1)=1,f(2)=2
public int numTrees(int n) {
        int[] array = new int[n+1];
        array[0] = 1;
        for (int i = 1; i <= n; i++) {
            int num = 0;
            for (int j = 0; j <=i-1; j++) {
                num += array[j]*array[i-1-j];
            }
            array[i] = num;
        }
        return array[n];
    }
递归解法
int[] cacheArray;
public int numTrees(int n) {
        if(n == 0 || n == 1){return 1;}
        if(n==2) {
            return 2;
        }
        if(cacheArray == null) {
            cacheArray = new int[n+1];
        } else if (cacheArray[n] !=0) {
            return cacheArray[n];
        }
        int sum = 0;
        for(int i = 0; i<n;i++) {
            sum+=numTrees(i)*numTrees(n-1-i);
        }
        cacheArray[n] = sum;
        return sum;
}
第239题-滑动窗口最大值
给你一个整数数组 nums,有一个大小为 k 的滑动窗口从数组的最左侧移动到数组的最右侧。你只可以看到在滑动窗口内的 k 个数字。滑动窗口每次只向右移动一位。 返回滑动窗口中的最大值。 示例 1: 输入:nums = [1,3,-1,-3,5,3,6,7], k = 3 输出:[3,3,5,5,6,7] 解释: 滑动窗口的位置 最大值
[1 3 -1] -3 5 3 6 7 3 1 [3 -1 -3] 5 3 6 7 3 1 3 [-1 -3 5] 3 6 7 5 1 3 -1 [-3 5 3] 6 7 5 1 3 -1 -3 [5 3 6] 7 6 1 3 -1 -3 5 [3 6 7] 7
解题思路
其实是可以维护一个已排序好的队列,每次将刚进窗口的值,添加到排序好的队列中,像插入排序的原理一样,然后取最大值的时候就去队列头部取,然后如果是超出窗口左边界的,就丢掉,没有超过就使用。但是主要问题在于每次插入时的平均时间复杂度是k/2,总时间复杂度就是Nk/2,当k接近于n时,这个复杂度就是O(N^2)了,所以在往队列中插入时,要有排除机制,假设队列是[6,5,4,2]四个数,此时要插入的元素是3,那么在插入时可以把2直接丢掉,因为元素2是3之前的元素,下标更小,值也比3小,在后面的遍历过程中是不可能再成为最大值的,所以通过把2删除掉,这样就可以减少插入时,比次数,将时间复杂度降低为O(N).
public int[] maxSlidingWindow(int[] nums, int k) {
        int[] result = new int[nums.length-k+1];
        LinkedList<Integer> maxQueue = new LinkedList<>();
        for (int i = 0; i < nums.length; i++) {
            //将队列中小于当前数的元素出队列
            while (maxQueue.size()>0 && nums[i] > nums[maxQueue.getLast()]) {
                maxQueue.removeLast();
            }
            maxQueue.add(i);
            //窗口的左边界
            int left = i - k+1;
            //将队列中出边界的最大值移除
            if (maxQueue.getFirst() <left) {
                maxQueue.removeFirst();
            }
            //左边界全部到数组中时,才需要计算最大值
            if (left>=0) {
                result[left] = nums[maxQueue.getFirst()];
            }
        }
        return result;
    }
第146题-LRU缓存机制
运用你所掌握的数据结构,设计和实现一个 LRU (最近最少使用) 缓存机制 。 实现 LRUCache 类:
LRUCache(int capacity) 以正整数作为容量 capacity 初始化 LRU 缓存 int get(int key) 如果关键字 key 存在于缓存中,则返回关键字的值,否则返回 -1 。 void put(int key, int value) 如果关键字已经存在,则变更其数据值;如果关键字不存在,则插入该组「关键字-值」。当缓存容量达到上限时,它应该在写入新数据之前删除最久未使用的数据值,从而为新的数据值留出空间。
解题思路
LinkedHashMap本身是基于HashMap做了一些扩展,就是通过链表将所有键值对连接起来了,链接的就是添加键值对的顺序。(新添加的键值对在链表尾部,put方法对于已存在的key进行值覆盖时,是不会修改键值对在链表中的顺序的) 所以我们可以基于LinkedHashMap实现LRU。 LRU的get()方法 1.map中不存在这个key,返回-1 2.map中存在这个key,先remove这个键值对,再put操作添加这个键值对,再返回value。(这样可以修改键值对在链表中的顺序。) LRU的put()方法 1.已存在这个key,先remove,再put。 2.不存在这个key,判断是否超过容量,超过将最后一个键值对移除,将键值对添加到map。
LinkedHashMap<Integer, Integer> map = new LinkedHashMap();
int capacity;

public LRUCache(int capacity) {
  	this.capacity = capacity;
}

public int get(int key) {
    Integer value = map.get(key);
    if (value == null) {
      return -1;
    }
    map.remove(key);
    map.put(key,value);
    return value;
}

public void put(int key, int value) {
    Integer oldValue = map.get(key);
    if (oldValue!=null) {
        //只是覆盖value的话,put方法不会改变键值对在链表中的顺序,所以需要先remove
        map.remove(key);
        map.put(key,value);
        return;
    }
    if (map.size()>=capacity) {
    	  map.remove(map.keySet().iterator().next());
    }
    map.put(key,value);
}
第236题-二叉树的最近公共祖先
给定一个二叉树, 找到该树中两个指定节点的最近公共祖先。
百度百科中最近公共祖先的定义为:“对于有根树 T 的两个结点 p、q,最近公共祖先表示为一个结点 x,满足 x 是 p、q 的祖先且 x 的深度尽可能大(一个节点也可以是它自己的祖先)。”
例如,给定如下二叉树: root = [3,5,1,6,2,0,8,null,null,7,4]
示例 1:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 1 输出: 3 解释: 节点 5 和节点 1 的最近公共祖先是节点 3。 示例 2:
输入: root = [3,5,1,6,2,0,8,null,null,7,4], p = 5, q = 4 输出: 5 解释: 节点 5 和节点 4 的最近公共祖先是节点 5。因为根据定义最近公共祖先节点可以为节点本身。
解题思路
其实所有的节点分为以下几种: 1.就是要寻找的节点1,或节点2 2.此节点子树中中包含节点1,节点2其中的一个 3.节点1,节点2全部位于此节点的左子树,或者是右子树 4.此节点左子树包含节点1,右子树包含节点2 所以第4种就是我们要寻找的节点,并且在二叉树中只有一个,所以我们对二叉树进行遍历,判断某个节点左子树,右子树都包含节点,那么就返回该节点。
TreeNode lowestCommonAncestor(TreeNode root, TreeNode node1, TreeNode node2) {
        if (root==null) {
            return null;
        }
        if (root==node1 || root==node2) {//当前节点就是要找的节点之一
            return root;
        }
        TreeNode leftNode = lowestCommonAncestor(root.left,node1,node2);//判断左子树中是否有节点
        TreeNode rightNode = lowestCommonAncestor(root.right,node1,node2);//判断右子树中是否有节点
        if (leftNode!=null&&rightNode!=null) {//就是我们要找的节点
            return root;
        } else if (leftNode!=null && rightNode==null) {//左子树中有节点,右子树没有节点,继续向上遍历
            return leftNode;
        } else if (leftNode==null && rightNode!=null) {//继续向上遍历
            return rightNode;
        }
        return null;
    }
第114题-二叉树展开为链表
给定一个二叉树,原地将它展开为一个单链表。
例如,给定二叉树
1
/
2 5
/ \
3 4 6
将其展开为:
1
2
3
4
5
6
解题思路
其实就是先序遍历,需要注意的是,需要先将节点的左右节点保存,然后再进行修改操作。其次是需要将所有节点的left指针置为null.
		TreeNode lastNode;//lastNode用于保存上一个遍历的节点
    public void flatten(TreeNode root) {
        if(root == null) {return;}
        TreeNode left = root.left;
        TreeNode right = root.right;
        if(lastNode==null) {
            lastNode = root;
            lastNode.left=null;
        } else {
            lastNode.left=null;
            lastNode.right = root;
            lastNode=root;
        }
        flatten(left);
        flatten(right);
    }
第84题-柱状图中最大的矩形
给定 n 个非负整数,用来表示柱状图中各个柱子的高度。每个柱子彼此相邻,且宽度为 1 。
求在该柱状图中,能够勾勒出来的矩形的最大面积。

以上是柱状图的示例,其中每个柱子的宽度为 1,给定的高度为 [2,1,5,6,2,3]。

图中阴影部分为所能勾勒出的最大矩形面积,其面积为 10 个单位。
示例:
输入: [2,1,5,6,2,3] 输出: 10
解题思路
可以暴力求解,就对每个height[i]都计算包含它的元素的最大高度,这样复杂度是O(N^2),计算的方法主要是对于每个i找到左边最后一个大于height[i]的边界left,和右边最后一个大于height[i]的边界right,
矩形面积=height[i]*(right-left+1),例如对于第五个柱子值为2的那个柱子来说,左边界left就是值为5的柱子,右边界就是值为3的柱子。
单调栈解法
理论就是假设f(i)代表包含圆柱i的最大矩形,那么其实就是在圆柱i的左边和右边各自找到第一个高度更小的圆柱k和j,f(i) = height[i]*(j-k+1)。所以可以使用单调栈来保存比当前圆柱高度height[i]小的元素,如果栈中元素高度比height[i]大,那么那些元素就需要出栈了。
可以使用一个栈Stack来保存左边圆柱高度比height[i]小的元素,也就是Stack中的值只能是比height[i]小的元素。栈底元素是最小的,栈顶元素高度是最大的。
遍历时,如果当前height[i]>栈顶元素的高度,说明当前栈顶元素还没有碰到比它小的数,所以还不能计算面积,就把height[i]入栈。
如果现在的height[i]<栈顶的元素高度小,说明栈顶元素碰到比它小的元素了,就需要出栈计算矩形面积,
面积=heights[j] * (i - left)
public int largestRectangleArea(int[] heights) {
        if (heights==null||heights.length==0) {
            return 0;
        }
        int maxArea = 0;
        Stack<Integer> stack = new Stack();
        stack.add(0);
        for (int i = 1; i <= heights.length; i++) {
            int currentH;
            if (i==heights.length) {
              //这是最后新增了一个0元素
              //防止整个数组是全体递增的,这样会计算不出面积
                currentH = 0;
            } else {
                currentH = heights[i];
            }

            if(currentH > heights[stack.peek()]) {
                stack.push(i);
            } else if (currentH == heights[stack.peek()]) {
                stack.pop();
                stack.push(i);
            } else {//当heights[i] < stack.peek()时,进行出栈计算
                while (stack.size()>0 && currentH<heights[stack.peek()]) {
                    Integer index = stack.pop();
                    //此时area的范围是[stack.peek()+1,i-1]
                    int leftIndex;
                    if (stack.size()>0) {
                        leftIndex = stack.peek() + 1;
                    } else {
                        leftIndex = 0;
                    }
                    int area = heights[index] * (i - leftIndex);
                    maxArea = maxArea > area ? maxArea : area;
                }
                stack.push(i);
            }
        }
        return maxArea;
    }
第148题-排序链表
给你链表的头结点 head ,请将其按 升序 排列并返回 排序后的链表 。
进阶:
你可以在 O(n log n) 时间复杂度和常数级空间复杂度下,对链表进行排序吗?
示例 1:

输入:head = [4,2,1,3] 输出:[1,2,3,4]
解题思路
就是归并排序
		ListNode preHead = new ListNode(1);
    ListNode sortList(ListNode start) {
      //归并排序划分到只有一个节点时,直接返回
        if (start.next == null || start==null) {return start;}
        ListNode quick = start;
        ListNode slow = start;
        while (quick!=null) {
            quick=quick.next;
            if (quick.next==null){break;}
            quick = quick.next;
            slow = slow.next;
        }
        //4 2 1 3
        ListNode otherStart = slow.next;
        slow.next = null;
        //对链表分解和合并后,新链表的头结点不一定还是start
        start = sortList(start);
        otherStart = sortList(otherStart);
        //开始merge
        //preHead用于我们来保存新组成的链表的头结点
        ListNode currentNode = preHead;
        while (start != null && otherStart!=null) {
            if (start.val<otherStart.val) {
                currentNode.next = start;
                currentNode=currentNode.next;
                start=start.next;
            } else {
                currentNode.next = otherStart;
                currentNode=currentNode.next;
                otherStart=otherStart.next;
            }
        }
        while (start!=null) {
            currentNode.next = start;
            currentNode=currentNode.next;
            start=start.next;
        }
        while (otherStart!=null) {
            currentNode.next = otherStart;
            currentNode=currentNode.next;
            otherStart=otherStart.next;
        }
        return preHead.next;
    }
第617题-合并二叉树
给定两个二叉树,想象当你将它们中的一个覆盖到另一个上时,两个二叉树的一些节点便会重叠。
你需要将他们合并为一个新的二叉树。合并的规则是如果两个节点重叠,那么将他们的值相加作为节点合并后的新值,否则不为 NULL 的节点将直接作为新二叉树的节点。
示例 1:
输入:
Tree 1 Tree 2
1 2
/ \ / \
3 2 1 3
/ \ \
5 4 7
输出:
合并后的树:
3
/
4 5
/ \ \
5 4 7
解题思路
		public TreeNode mergeTrees(TreeNode t1, TreeNode t2) {
        if(t1==null || t2==null) {
            return t1==null? t2 : t1;
        }
        t1.val = t1.val+t2.val;
        t1.left = mergeTrees(t1.left,t2.left);
        t1.right = mergeTrees(t1.right,t2.right);
        return t1;
    }
第287题-寻找重复数
给定一个包含 n + 1 个整数的数组 nums,其数字都在 1 到 n 之间(包括 1 和 n),可知至少存在一个重复的整数。假设只有一个重复的整数,找出这个重复的数。
示例 1:
输入: [1,3,4,2,2] 输出: 2 示例 2:
输入: [3,1,3,4,2] 输出: 3 说明:
不能更改原数组(假设数组是只读的)。 只能使用额外的 O(1) 的空间。 时间复杂度小于 O(n2) 。 数组中只有一个重复的数字,但它可能不止重复出现一次。
解题思路
这个题主要是不能使用额外的辅助空间,不然可以使用一个数组或者HashMap记录遍历过程中出现的整数,然后判断当前数是否重复。本题只能使用数组本身来记录整数是否出现,所以可以将每个数nums[i]交换到以nums[i]作为下标的地方,如果此时以存在相同的数,说明重复,否则就对交换后的数继续遍历。
第152题-乘积最大子数组
给你一个整数数组 nums ,请你找出数组中乘积最大的连续子数组(该子数组中至少包含一个数字),并返回该子数组所对应的乘积。
示例 1:
输入: [2,3,-2,4] 输出: 6 解释: 子数组 [2,3] 有最大乘积 6。 示例 2:
输入: [-2,0,-1] 输出: 0 解释: 结果不能为 2, 因为 [-2,-1] 不是子数组。
解题思路
因为本题所有的都是整数,所以乘积肯定是越乘越大,只有碰到0会变成0,碰到负数会符号改变,所以主要分为以下几种情况:
1.数组中没有0存在
1.1 负数的个数为偶数个 最大值就是所有元素的乘积 1.2 负数的个数为奇数个 那么最大值就是第一个负数后面的所有的元素的乘积,或者是最后一个负数前面所有元素的乘积
2.假设数组中有0存在
那么其实就是根据0将数组切分成子数组了,对每个子数组计算最大值。
public int maxProduct(int[] nums) {
        if (nums == null || nums.length == 0) {
            return 0;
        }
        if (nums.length == 1) {
            return nums[0];
        }
        int start = 0;
        int max = 0;
        int times = 0;
        //根据0对数组进行切分,对每个子数组计算最大乘积和
        for (int i = 0; i < nums.length; i++) {
            if (nums[i] <0) {//统计负数的个数
                times++;
            }
            if (nums[i] == 0 || i == nums.length-1) {
                int end = nums[i] == 0 ? i-1 : i;
                int value = maxProduct(nums,start,end,times);
                start=i+1;
                max = max>value?max:value;
                times =0;
            }
        }
        return max;
    }
    public int maxProduct(int[] nums,int start,int end,int times) {
        if (start>end) {
            return 0;
        }
        if (start==end) {
            return nums[start];
        }
        if (times%2 == 0) {//负数为偶数个
            return calculateValue(nums,start,end);
        } else {//
            //第一个负数的下标
            Integer firstNegativeIndex=null;
            //最后一个负数的下标
            Integer lastNegativeIndex=null;
            for (int i = start; i <= end; i++) {
                if (nums[i] < 0 && firstNegativeIndex == null) {
                    firstNegativeIndex = i;
                }
                if (nums[i] < 0) {
                    lastNegativeIndex = i;
                }
            }
            int vaule1 = calculateValue(nums,start,lastNegativeIndex-1);
            int value2 = calculateValue(nums,firstNegativeIndex+1,end);
            return vaule1>value2?vaule1:value2;
        }
    }
    //计算start到end之间的元素乘积和
    int calculateValue(int[] nums, int start, int end) {
        if (start>end) {
            return 0;
        }
        int result = 1;
        for (int i = start; i <= end; i++) {
            result*=nums[i];
        }
        return result;
    }
第72题-编辑距离
给你两个单词 word1 和 word2,请你计算出将 word1 转换成 word2 所使用的最少操作数 。
你可以对一个单词进行如下三种操作:
插入一个字符 删除一个字符 替换一个字符
示例 1:
输入:word1 = "horse", word2 = "ros" 输出:3 解释: horse -> rorse (将 'h' 替换为 'r') rorse -> rose (删除 'r') rose -> ros (删除 'e')
解题思路
就是我们要把word1转换为word2,从word2第一个字符开始遍历,对于每一个字符而言,i,j分别为word1和word2当前遍历的位置有四种选择:
1.直接跳过
当words[i]与word[j]相同时,简单举例来说,就是假设要把"acc"转换为"abb",由于第一个字符相同,那么编辑的步数其实是等于"cc"转换为"bb"的步数 所以假设使用restLength[i][j]代表剩余子串需要的步数,
restLength[i][j] = restLength[i+1][j+1]
2.将word1[i]删除
假设我们要将"abcd"转换为"bc",那么其实我们可以将a删除掉,相当于对于word1跳过了当前字符,继续遍历
restLength[i][j] = restLength[i+1][j]
3.在word1[i]前增加新字符word2[j]
假设我们要将"bbb"转换为"abbb",那么就可以对于word1增加一个word2当前的字符,然后继续遍历,相当于是对word2的字符跳过了
restLength[i][j] = restLength[i][j+1]
4.对word1[i]替换成word2[j]
假设我们要将"abbb"转换为"cbbb",那么直接将a替换成c就好了,相当于对word1和word2字符串都跳过了当前字符
restLength[i][j] = restLength[i+1][j+1]
代码
    int[][] cacheLength;
    public int minDistance(String word1, String word2) {
        if (word1==null||word2==null) {
            return 0;
        }
        cacheLength = new int[word1.length()+1][word2.length()+1];
        return minDistance(word1,word2,0,0);
    }

    public int minDistance(String word1, String word2,int i,int j) {
        //当有一个字符串已经走到末尾了,要变成另一个字符串只能是将另一个字符串剩余字符全部添加过来
        if (cacheLength[i][j]!=0) {
            return cacheLength[i][j];
        }
        if (i == word1.length()) {
            return word2.length() - j;
        }
        if (j == word2.length()) {
            return word1.length() - i;
        }
        if (word1.charAt(i) == word2.charAt(j)) {//相等就直接向后移动
            return minDistance(word1,word2,i+1,j+1);
        }
        //这一步选择删除,那么就是将word1的当前字符删除
        int deleteLength = minDistance(word1,word2,i+1,j) + 1;
        //这一步选择插入,就是将word2的当前字符插入到word1
        int insertLength = minDistance(word1,word2,i,j+1) + 1;
        //这一步走替换,就是将word2的当前字符替换到word1
        int replaceLength = minDistance(word1,word2,i+1,j+1) + 1;
        //选择上面三种路线中最短的
        int min = deleteLength < insertLength ? deleteLength : insertLength;
        min = replaceLength < min ? replaceLength : min;
        cacheLength[i][j] = min;
        return min;
    }
第139题-单词拆分
给定一个非空字符串 s 和一个包含非空单词的列表 wordDict,判定 s 是否可以被空格拆分为一个或多个在字典中出现的单词。
说明:
拆分时可以重复使用字典中的单词。 你可以假设字典中没有重复的单词。 示例 1:
输入: s = "leetcode", wordDict = ["leet", "code"] 输出: true 解释: 返回 true 因为 "leetcode" 可以被拆分成 "leet code"。 示例 2:
输入: s = "applepenapple", wordDict = ["apple", "pen"] 输出: true 解释: 返回 true 因为 "applepenapple" 可以被拆分成 "apple pen apple"。 注意你可以重复使用字典中的单词。
解题思路
就是对于字符串"abc"来说,可以拆分成"a"和"bc",如果说字典中存在"a",我们只需要递归调用函数对剩余字符"bc"进行判断,判断"bc"是否能分解。最坏复杂度应该是O(N^2)。这里优化的点就是每次判断时,如果计算得到子串"bc"不能被分解,我们应该将它添加到falseSet,避免重复计算。
HashSet<String> falseSet = new HashSet<String>();
    public boolean wordBreak(String s, List<String> wordDict) {
        if (s==null||s.length()==0) {return true;}
        if (falseSet.contains(s)) {
            return false;
        }
        HashSet<String> wordSet = new HashSet<>(wordDict);
        for (int i = 0; i < s.length(); i++) {
            //当前子串
            String subString = s.substring(0,i+1);
            //剩余子串
            String restString = s.substring(i+1,s.length());
            //如果剩余子串存在,那么就分解成功了
            if (wordSet.contains(subString) && wordBreak(restString, wordDict)) {
                return true;
            }
        }
        //分解不成功,将子串添加到falseSet,避免重复计算
        falseSet.add(s);
        return false;
    }
第76题-最小覆盖子串
给你一个字符串 s 、一个字符串 t 。返回 s 中涵盖 t 所有字符的最小子串。如果 s 中不存在涵盖 t 所有字符的子串,则返回空字符串 "" 。
注意:如果 s 中存在这样的子串,我们保证它是唯一的答案。
示例 1:
输入:s = "ADOBECODEBANC", t = "ABC" 输出:"BANC"
解题思路
首先本题的最小子串是不需要保证子串的顺序的,也就是子串是ABC,我们的最小覆盖子串是BANC也可以,不一定非需要保证ABC的顺序。其实就是滑动窗口,我们用一个needMap来记录,key是需要查找的子串的字符,value是字符从次数。然后就用两个指针作为滑动窗口来遍历字符串,滑动窗口中字符及出现的次数用windowMap来存储,
1.然后每次右指针移动,获取新进入窗口的字符,更新windowMap,如果当前字符是needMap中存在的,且windowMap该字符出现次数已达标,那么就更新needSize(子串中的字符在窗口中出现的次数)。
2.左指针进行移动,判断当前字符是否能移除窗口,(如果是子串需要的,且在窗口出现的次数<=子串需要的次数,就不能移除)
3.判断当前needSize是否达标,达标说明当前窗口就是一个覆盖子串,如果比之前最小的覆盖子串小,那么就进行替换。
public String minWindow(String s, String t) {
        //needMap的key就是字符串t中出现的每个字符,value就是这个字符出现的次数
        HashMap<Character,Integer> needMap = new HashMap<>();
        //windowMap就是滑动窗口中当前字符及字符出现次数
        HashMap<Character,Integer> windowMap = new HashMap<>();
        for(int i = 0;i<t.length();i++) {
            Character key = t.charAt(i);
            Integer times = needMap.get(key);
            //times记录的是字符出现次数,不存在就赋初值1,已存在就+1,
            times = times == null ? 1 : times+1;
            needMap.put(key, times);
        }
        int left = 0;
        int right =0 ;
        //子串中的字符在窗口中出现的次数
        int needSize=0;
        String minStr = "";
        while(right<s.length()) {
            Character rightChar = s.charAt(right);
            Integer needTimes = needMap.get(rightChar);
            Integer windowTimes = windowMap.get(rightChar);
            //字符在窗口第一次出现,次数就是1,否则就+1
            windowTimes = windowTimes == null? 1 : windowTimes+1;
            windowMap.put(rightChar,windowTimes);
            if(needTimes==null){//说明该字符不在最小子串里面
                right++;
                continue;
            } else if(needTimes!=null && needTimes.equals(windowTimes)) {//说明该字符在最小子串里面,并且窗口中包含次字符已达标
                needSize+=windowTimes;
            }
            //缩小窗口
            while(left<=right) {
                Character currentLeftChar = s.charAt(left);
                Integer leftNeedTimes = needMap.get(currentLeftChar);
                Integer leftWindowTimes =  windowMap.get(currentLeftChar);
                if(leftNeedTimes == null) {//说明不需要这个字府
                    left++;
                } else if (leftWindowTimes > leftNeedTimes) {//需要这个字符,且所包含该字符个数大于需要的,可以左移
                    windowMap.put(currentLeftChar,leftWindowTimes-1);
                    left++;
                } else if(leftWindowTimes <= leftNeedTimes){//需要该字符,并且窗口不能左移
                    break;
                }
            }
            //判断当前窗口是否满足需求
            if(needSize >= t.length() && (minStr.equals("") || right-left+1 < minStr.length())) {
                minStr = s.substring(left,right+1);
            }
            right++;
        }
        return minStr;
    }
第124题-二叉树中的最大路径和
给定一个非空二叉树,返回其最大路径和。
本题中,路径被定义为一条从树中任意节点出发,沿父节点-子节点连接,达到任意节点的序列。该路径至少包含一个节点,且不一定经过根节点。
示例 1:
输入:[1,2,3]
   1
  / \
 2   3
输出:6 示例 2:
输入:[-10,9,20,null,null,15,7]
-10
/
9 20
/
15 7
输出:42
解题思路
这个题由于不要求路径开始和路径结束的节点是叶子节点,所以是有点复杂,我们可以先定义一个函数,这个函数可以计算每个节点单条路径的长度,就是可以是节点本身,也可以是节点+左子树中的节点连接,也可以是节点+左子树中的节点连接,但是节点不能既连接左节点,由连接右节点。在遍历过程中,可以得到(根节点,根节点+左子树路径最大值,根节点+右子树路径最大值)三者的最大值,然后进行返回。在遍历的过程中,由于我们知道左子树路径最大值和右子树路径最大值,我们可以计算以该节点为根节点的路径最大值,然后与totalMax进行比较和替换。
//因为最大路径出现时,肯定是有一个根节点的,所以在计算单条路径时,
    // 可以同时计算最大路径和,然后存储到totalMax
    Integer totalMax = Integer.MIN_VALUE;
    public int maxPathSum(TreeNode root) {
        siglePath(root);
        return totalMax;
    }

    //这里计算的是单条路径长度,就是根节点+左路+右路的
    // 根节点,根节点+左节点中的路径,根节点+右节点中的路径
    //但是不能是左节点中的路径+根节点+右节点的路径
    public int siglePath(TreeNode root) {
        if (root == null) {
            return 0;
        }
        //左边单条路径的长度
        int leftPath = siglePath(root.left);
        leftPath = leftPath>0?leftPath:0;
        int rightPath = siglePath(root.right);
        rightPath = rightPath>0?rightPath:0;
        //根节点+左路大,还是根节点+右路大
        int max = leftPath > rightPath ?
                leftPath + root.val : rightPath + root.val;
        //实时计算左路单条路径+根节点+右路单条路径哪个大
        totalMax = leftPath+rightPath+root.val > totalMax ? leftPath+rightPath+root.val : totalMax;
        return max;
    }
第461题-汉明距离
两个整数之间的汉明距离指的是这两个数字对应二进制位不同的位置的数目。 给出两个整数 x 和 y,计算它们之间的汉明距离。 注意: 0 ≤ x, y < 2的31次方.
示例:
输入: x = 1, y = 4
输出: 2
解释: 1 (0 0 0 1) 4 (0 1 0 0) ↑ ↑ 上面的箭头指出了对应二进制位不同的位置。
解题思路
public int hammingDistance(int x, int y) {
        int result = x^y;
        int num=0;
        while(result>0) {
          if((result&1) == 1) {
            num++;
          }
          result = result>>1;
        }
        return num;
}
第128题-最长连续序列
给定一个未排序的整数数组 nums ,找出数字连续的最长序列(不要求序列元素在原数组中连续)的长度。 进阶:你可以设计并实现时间复杂度为 O(n) 的解决方案吗? 示例 1: 输入:nums = [100,4,200,1,3,2] 输出:4 解释:最长数字连续序列是 [1, 2, 3, 4]。它的长度为 4。 示例 2: 输入:nums = [0,3,7,2,5,8,4,6,0,1] 输出:9
解题思路
就是先使用HashMap存储各个值,然后遍历键值对,判断每个键值对周围的数字是否存在。这里做的优化点就是HashMap的key存的就是数组中出现的元素,value存的是一个区间,代表的是连续数组的左右边界。
public int longestConsecutive(int[] nums) {
        HashMap<Integer, List<Integer>> map = new HashMap<>();
        //遍历数组,key就是数组中的元素,value记录的是连续子数组的左右边界
        //value初始区间只包含一个元素,就是[key,key]
        for (int i = 0; i < nums.length; i++) {
            List<Integer> list = new ArrayList<>();
            list.add(nums[i]);
            list.add(nums[i]);
            map.put(nums[i],list);
        }
        Integer max = 0;
        //根据每个key去判断左右元素是否存在,计算最大区间
        for (Integer key: map.keySet()) {
            List <Integer> list = map.get(key);
            int left = list.get(0)-1;
            int right = list.get(1)+1;
            //向左扩展
            while (map.containsKey(left)) {
                List<Integer> currentList = map.get(left);
                list.set(0,currentList.get(0));
                left = currentList.get(0) - 1;
            }
            //向右扩展
            while (map.containsKey(right)) {
                List<Integer> currentList = map.get(right);
                list.set(1,currentList.get(1));
                right = currentList.get(1) + 1;
            }
            int currentValue = list.get(1) - list.get(0) + 1;
            max = max > currentValue ? max : currentValue;
        }
        return max;
    }
第647题-回文子串
给定一个字符串,你的任务是计算这个字符串中有多少个回文子串。 具有不同开始位置或结束位置的子串,即使是由相同的字符组成,也会被视作不同的子串。
示例 1: 输入:"abc" 输出:3 解释:三个回文子串: "a", "b", "c"
示例 2: 输入:"aaa" 输出:6 解释:6个回文子串: "a", "a", "a", "aa", "aa", "aaa"
解题思路
这个题本身没有什么技巧,就是就是对每个字符,从中心往两边扩展,判断是否是回文串,一旦发现不是回文串,后面就不需要继续扩展了。需要注意的是,回文串分为奇数回文串,偶数回文串,所以中心可以是当前单个字符,也可以是当前字符+右边的字符。
 int num=0;
    public int countSubstrings(String s) {
        char[] array = s.toCharArray();
        for (int i = 0; i < array.length; i++) {
            //奇数回文串
            calculateNum(array,i,i);
            //偶数回文串
            calculateNum(array,i,i+1);
        }
        return num;
    }

    void calculateNum(char[] array,int start,int end) {
        while (start>=0 && end<array.length && array[start] == array[end]) {
            num++;
            start--;
            end++;
        }
    }
第337题-打家劫舍III
在上次打劫完一条街道之后和一圈房屋后,小偷又发现了一个新的可行窃的地区。这个地区只有一个入口,我们称之为“根”。 除了“根”之外,每栋房子有且只有一个“父“房子与之相连。一番侦察之后,聪明的小偷意识到“这个地方的所有房屋的排列类似于一棵二叉树”。 如果两个直接相连的房子在同一天晚上被打劫,房屋将自动报警。
计算在不触动警报的情况下,小偷一晚能够盗取的最高金额。
示例 1:
输入: [3,2,3,null,3,null,1]
 3
/ \
2 3 \ \ 3 1
输出: 7 解释: 小偷一晚能够盗取的最高金额 = 3 + 3 + 1 = 7.
解题思路
就是递归遍历,对于每个根节点而言,遍历时有两种选择: 1.如果它的父节点没有被选择,它可以被选择,那么有两种情况: 1.1 选择当前节点,那么子节点不能被选择 1.2没有选择当前节点,子节点也可以被选择
2.如果它的父节点被选了, 那么当前节点不能被选择,只能是它的左右子节点可以被选择
		public int rob(TreeNode root) {
        return rob(root,true);
    }
    public int rob(TreeNode root,Boolean rootCanChoose) {
        if (root ==null) {return 0;}
        int max = 0;
        if (rootCanChoose) {//当前根节点可以被选择
            //选择了根节点
            int value1 = root.val+rob(root.left,false) + rob(root.right,false);
            //没有选择根节点
            int value2 = rob(root.left,true) + rob(root.right,true);
            max = value1 > value2 ? value1 : value2;
        } else {//当前根节点不能被选择
            max = rob(root.left,true) + rob(root.right,true);
        }
        return max;
    }
第238题-除自身以外数组的乘积
给你一个长度为 n 的整数数组 nums,其中 n > 1,返回输出数组 output ,其中 output[i] 等于 nums 中除 nums[i] 之外其余各元素的乘积。
示例:
输入: [1,2,3,4] 输出: [24,12,8,6]
解题思路
就是对于位置i,本题要求去求nums[0]*nums[1]...nums[i-1]nums[i+1]...nums[length-1],不能用除法,认识要求的这个乘积可以分成两部分,一部分是i以前的部分,nums[0]*nums[1]...nums[i-1],一部分是nums[i+1]...nums[length-1],所以可以先分别计算出left数组,对于每个元素存在0到i的乘积,计算right数组,对于每个元素,计算i到length-1的乘积。
		public int[] productExceptSelf(int[] nums) {
        int[] left = new int[nums.length];
        int[] right = new int[nums.length];
        int[] result = new int[nums.length];
        int temp =1;
      	//left[i]存储的是nums[0]到nums[i]的乘积
        for (int i = 0; i < nums.length; i++) {
            temp = temp*nums[i];
            left[i] = temp;
        }
        temp = 1;
        //right[i]存储的是nums[i]到nums[length-1]的乘积
        for (int i = nums.length-1; i >=0 ; i--) {
            temp = temp * nums[i];
            right[i] = temp;
        }
        for (int i = 0; i < nums.length; i++) {
            int leftValue = i-1 >= 0 ? left[i-1] : 1;
            int rightValue = i+1 < nums.length ? right[i+1] : 1;
            result[i] = leftValue * rightValue;
        }
        return result;
    }
第207题-课程表
你这个学期必须选修 numCourse 门课程,记为 0 到 numCourse-1 。
在选修某些课程之前需要一些先修课程。 例如,想要学习课程 0 ,你需要先完成课程 1 ,我们用一个匹配来表示他们:[0,1]
给定课程总量以及它们的先决条件,请你判断是否可能完成所有课程的学习?
示例 1:
输入: 2, [[1,0]] 输出: true 解释: 总共有 2 门课程。学习课程 1 之前,你需要完成课程 0。所以这是可能的。 示例 2:
输入: 2, [[1,0],[0,1]] 输出: false 解释: 总共有 2 门课程。学习课程 1 之前,你需要先完成课程 0;并且学习课程 0 之前,你还应先完成课程 1。这是不可能的。
解题思路
其实就是判断有向图是否存在环,有两种解法
深度优先遍历
就是先根据二维数组构建一个邻接表,这里我们使用一个map来作为领接表,然后递归遍历map中的节点,对于图中每个节点有三种状态:
1.未被访问过(在statusMap中值为null)。
2.已被访问过,并且它的子节点没有遍历访问完成(在statusMap中值为1)。
3.已被访问过,并且子节点也遍历访问完成(在statusMap中值为2)。
在递归遍历过程中,遇到上面第2种节点,说明就存在环。
public boolean canFinish(int numCourses, int[][] prerequisites) {
        HashMap<Integer, List<Integer>> map = new HashMap<>();
        //构建邻接表
        for (int i = 0; i < prerequisites.length; i++) {
            Integer key = prerequisites[i][0];
            List<Integer> valueList = map.get(key);
            if (valueList == null) {
                valueList = new ArrayList<>();
            }
            valueList.add(prerequisites[i][1]);
            map.put(key,valueList);
        }
        HashMap<Integer,Integer> statusMap = new HashMap<>();
        for (Integer key : map.keySet()) {
             if (judgeIfHasCircle(map,statusMap,key)) {//有环
                 return false;
             }
        }
        return true;
    }
        //判断每个节点是否存在环
    boolean judgeIfHasCircle(HashMap<Integer, List<Integer>> map, HashMap<Integer,Integer> statusMap,Integer key) {
        Integer status = statusMap.get(key);
        if (status== null) {
            statusMap.put(key,1);
        } else if (status==1) {
            return true;
        } else if (status == 2) {
            return false;
        }

        List<Integer> valueList = map.get(key);
        if (valueList!=null) {
        //遍历子节点
            for (Integer everyKey : valueList) {
                if (judgeIfHasCircle(map, statusMap, everyKey)) {
                    return true;
                }
            }
        }
        //代表子节点遍历完毕
        statusMap.put(key,2);
        return false;
    }
拓扑排序
这种解法有点像是宽度优先遍历,就是先建立邻接表,并且计算每个节点的入度,然后找到入度为0的节点(也就是没有被其他节点指向的节点),将它们入队列,然后对队列元素进行出队操作,取出队首元素,将它的子节点的入度都-1,然后子节点入度减到0时,就将这个子节点添加到队列中,在过程中会统计入过队列的节点数。原理就是如果没有环的,最终队列出队完成后,进入过队列的节点数是等于总节点数的。就是假设图的结构是1->2,2->3,3->4,4->2,也就是2,3,4形成一个环,最开始1是入度为0的节点,1会入队列,然后对节点2的入度-1,节点2的入度还剩下1,此时2不会入队列,所以最终进过队列的元素只有节点1,所以最终统计的数量是<总节点数的(如果不存在环,则所有节点的入度都会变成0,也就是结果集中的节点树会等于总节点数)。
第309题-最佳买卖股票时机含冷冻期
给定一个整数数组,其中第 i 个元素代表了第 i 天的股票价格 。
设计一个算法计算出最大利润。在满足以下约束条件下,你可以尽可能地完成更多的交易(多次买卖一支股票):
你不能同时参与多笔交易(你必须在再次购买前出售掉之前的股票)。 卖出股票后,你无法在第二天买入股票 (即冷冻期为 1 天)。
dp[i][0]//代表不持有股票
dp[i][1]//代表持有股票

  //如果今天不持有股票,要么是之前没有股票,要么是卖了股票
  dp[i][0] = max(dp[i-1][0],dp[i-1][1] + value[i])
  //如果今天持有股票,要么是之前就持有,要么是今天新买的
  dp[i][1] = max(dp[i-1][1],dp[i-2][0] - value[i])
示例:
输入: [1,2,3,0,2] 输出: 3 解释: 对应的交易状态为: [买入, 卖出, 冷冻期, 买入, 卖出]
解题思路
这个跟上一题的区别就是有冷冻期,就是当你第i天要持有股票时,要么是第i-1天已持有股票,要么是第i-1天没有买卖股票才能在第天买股票。 卖出股票后,你无法在第二天买入股票 (即冷冻期为 1 天)。
  //如果今天不持有股票,要么是之前没有股票,要么是第i天卖了股票
  dp[i][0] = max(dp[i-1][0],dp[i-1][1] + value[i])
  //如果今天持有股票,要么是之前就持有,要么是第i天新买的
  dp[i][1] = max(dp[i-1][1],dp[i-2][0] - value[i])
代码
    public int maxProfit(int[] prices) {
        if(prices==null||prices.length<=1) {return 0;}
        int[][] dp = new int[prices.length][2];
        dp[0][0] = 0;
        dp[0][1] = 0 - prices[0];
        dp[1][0] = prices[1]-prices[0] < 0 ? 0 : prices[1]-prices[0];
        dp[1][1] = 0-prices[1] > 0- prices[0]? 0-prices[1] : 0-prices[0];
        for (int i = 2; i < prices.length; i++) {
            dp[i][0] = Math.max(dp[i-1][1]+prices[i], dp[i-1][0]);
            dp[i][1] = Math.max(dp[i-2][0]-prices[i],dp[i-1][1]);
        }
        return dp[prices.length-1][0];
    }
这一题的时间复杂度为O(N),空间复杂度也为O(N),有一个可以优化的点就是d[i]只依赖于dp[i-1]和dp[i-2],所以理论上我们只需要一个几个常数变量就可以了,空间复杂度为O(1);
public int maxProfit1(int[] prices) {
        if(prices==null||prices.length<=1) {return 0;}
        int last_last_0 = 0;
        int last_0 = prices[1]-prices[0] < 0 ? 0 : prices[1]-prices[0];
        int last_1 = 0-prices[1] > 0- prices[0]? 0-prices[1] : 0-prices[0];
        for (int i = 2; i < prices.length; i++) {
            int temp_0 = last_0;
            last_0 = Math.max(last_1+prices[i], last_0);
            last_1 = Math.max(last_last_0-prices[i],last_1);
            last_last_0 = temp_0;
        }
        return last_0;
    }
第416题-分割等和子集
给定一个只包含正整数的非空数组。是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。
注意: 每个数组中的元素不会超过 100 数组的大小不会超过 200 示例 1: 输入: [1, 5, 11, 5] 输出: true 解释: 数组可以分割成 [1, 5, 5] 和 [11].
解题思路
本题就是可以转化为从数组中挑选i个元素,最终使和为数组和的一半,所以就转换为01背包问题了,只不过判断条件由选择让装的物品价值更大,变为装的物品的价值正好是总价值的一半。
public boolean canPartition(int[] nums) {
        if (nums==null||nums.length==0) {
            return false;
        }
        int sum = 0;
        for (int i = 0; i < nums.length; i++) {
            sum+=nums[i];
        }
        if (sum%2==1) {
            return false;
        } else {
            return canPartition(nums,nums.length-1,sum/2);
        }
    }
    //使用HashMap缓存结果,避免重复计算
    HashMap<String,Boolean> resultCacheMap = new HashMap<String,Boolean>();
    //判断在0到i-1这些元素中进行能选择,看能否选择出的元素和为sum
    public boolean canPartition(int[] nums,int i,int sum) {
        if (sum<0) { return false; }
        if (sum==0) { return true; }
        if (i<0) { return false; }
        if (i==0) {//只有一个元素了
            return nums[0]==sum;
        }
        String key = i+"-"+sum;
        if (resultCacheMap.containsKey(key)) {
            return resultCacheMap.get(key);
        }
        //选择元素i,看剩下的元素能否凑出sum 和不选择元素i
        boolean result = canPartition(nums,i-1,sum-nums[i]) || canPartition(nums,i-1,sum);
        resultCacheMap.put(key,result);
        return result;
    }
第560题-和为K的子数组
给定一个整数数组和一个整数 k,你需要找到该数组中和为 k 的连续的子数组的个数。 示例 1 : 输入:nums = [1,1,1], k = 2 输出: 2 , [1,1] 与 [1,1] 为两种不同的情况。 说明 : 数组的长度为 [1, 20,000]。 数组中元素的范围是 [-1000, 1000] ,且整数 k 的范围是 [-1e7, 1e7]。
解题思路
假设一个数组nums的元素为[a1,a2,a3,a4],假设我们使用f(a,b)代表从数组下标a到数组下标b的连续子数组和,f(a,b)=f(0,b)-f(0,a),也就是说假设子数组的和[a2,a3]=[a1,a2,a3]-[a1],所以k = [a1,a2,a3]-[a1],我们判断和为k的数量,其实也就判断从0开始的子树组之间的差为k的数量,所以我们计算将从下标为0的数组的和,添加到HashMap中去,然后遍历时进行判断。
 public int subarraySum(int[] nums, int k) {
        if (nums==null||nums.length==0) { return 0; }
        int matchTimes=0;
        int sum=0;
        HashMap<Integer,Integer> sumMap = new HashMap<>();
        //这个主要是为了统计为从0到i的和为sum的子数组
        sumMap.put(0,1);
        for (int i = 0; i < nums.length; i++) {
            sum+=nums[i];
            int key =  sum - k;
            if (sumMap.containsKey(key)) {
                matchTimes+=sumMap.get(key);
            }
            //将当前sum和添加到map中去
            Integer times = sumMap.get(sum);
            if (times==null) {
                times=0;
            }
            sumMap.put(sum,times+1);
        }
        return matchTimes;
    }
第448题-找到所有数组中消失的数字
给定一个范围在 1 ≤ a[i] ≤ n ( n = 数组大小 ) 的 整型数组,数组中的元素一些出现了两次,另一些只出现一次。 找到所有在 [1, n] 范围之间没有出现在数组中的数字。 您能在不使用额外空间且时间复杂度为O(n)的情况下完成这个任务吗? 你可以假定返回的数组不算在额外空间内。 示例:
输入: [4,3,2,7,8,2,3,1]
输出: [5,6]
解题思路
这个题因为数字a的取值都是[1,nums.length]之间,所以a-1应该是在[0,nums.length-1]之间,正好跟数组的下标可以对应上,所以对数组遍历,将数字a放到下标a-1下,如果 1.当前数字a如果为-1那么就不用调整位置了,因为这是我们设置的标志位,如果a正好等于下标i+1,也不用调整,因为是正确的位置 2.如果下标a-1正好存的也是a,那么说明是出现两次的元素,那么将那个位置标志位-1,也不用调整了 3.将当前元素a与下标a-1的元素交换,继续遍历。
public List<Integer> findDisappearedNumbers(int[] nums) {
        List<Integer> list = new ArrayList<>();
        if (nums==null||nums.length==0) {
            return list;
        }
        for (int i = 0; i < nums.length; i++) {
            int index = nums[i] - 1;
            if (nums[i] == -1 || nums[i] == i+1) {//说明是未出现过的数字,或者是已经调整到正确位置的数字,直接跳过
                continue;
            } else if (nums[index] == index+1) {//说明这个位置已经有这个元素了,是出现两次的元素
                nums[i] = -1;
            } else {//否则是出现一次的元素,进行交换
                int temp = nums[index];
                nums[index] = nums[i];
                nums[i] = temp;
                i--;
            }
        }
        for (int i = 0; i < nums.length; i++) {
            if (nums[i] == -1) {
                list.add(i+1);
            }
        }
        return list;
    }
第437题-路径总和III
给定一个二叉树,它的每个结点都存放着一个整数值。
找出路径和等于给定数值的路径总数。
路径不需要从根节点开始,也不需要在叶子节点结束,但是路径方向必须是向下的(只能从父节点到子节点)。
二叉树不超过1000个节点,且节点数值范围是 [-1000000,1000000] 的整数。
示例:
root = [10,5,-3,3,2,null,11,3,-2,null,1], sum = 8
10
/
5 -3
/ \
3 2 11
/ \
3 -2 1
返回 3。和等于 8 的路径有:
- 5 -> 3
- 5 -> 2 -> 1
- -3 -> 11
解题思路
其实就是对每个节点作为起始节点,开始向下遍历,计算路径和,每当路径和为sum时,就对数量+1。
int pathNum = 0;
    //这个方法主要负责对二叉树遍历
    public int pathSum(TreeNode root, int sum) {
        if (root==null) { return 0; }
        //必须包含根节点的
        pathSumMustHasRoot(root,sum,0);
        //不包含根节点的
        pathSumMustHasRoot(root.left,root.val);
        pathSumMustHasRoot(root.right,root.val);
        return pathNum;
    }
    //对每个节点计算路径和,然后继续向下
    void pathSumMustHasRoot(TreeNode root,int sum,int currentSum) {
        if (root == null) {return ;}
        currentSum+=root.val;
        if (currentSum == sum) {
            pathNum++;
        }
        pathSumMustHasRoot(root.left,sum,currentSum);
        pathSumMustHasRoot(root.right,sum,currentSum);
    }
第338题-比特位计数
给定一个非负整数 num。对于 0 ≤ i ≤ num 范围中的每个数字 i ,计算其二进制数中的 1 的数目并将它们作为数组返回。
示例 1:
输入: 2 输出: [0,1,1] 示例 2:
输入: 5 输出: [0,1,1,2,1,2]
解题思路
因为i&(i-1)的结果相当于是去掉了最右边的一个1,所以 i中1的数量 = i&(i-1)中1的数量 + 1,所以可以使用一个数组保存以前的数的1的数量,这样就可以以O(1)的时间复杂度计算中1的数量。
public int[] countBits(int num) {
//i & (i-1)可以将最右边的0去掉
        int[] bitCountArray = new int[num+1];
        bitCountArray[0] = 0;
        for (int i = 1; i <= num; i++) {
            bitCountArray[i] = bitCountArray[i&(i-1)] +1;
        }
        return bitCountArray;
    }
第406题-根据身高重建队列
假设有打乱顺序的一群人站成一个队列,数组 people 表示队列中一些人的属性(不一定按顺序)。每个 people[i] = [hi, ki] 表示第 i 个人的身高为 hi ,前面 正好 有 ki 个身高大于或等于 hi 的人。
请你重新构造并返回输入数组 people 所表示的队列。返回的队列应该格式化为数组 queue ,其中 queue[j] = [hj, kj] 是队列中第 j 个人的属性(queue[0] 是排在队列前面的人)。
示例 1:
输入:people = [[7,0],[4,4],[7,1],[5,0],[6,1],[5,2]] 输出:[[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]] 解释: 编号为 0 的人身高为 5 ,没有身高更高或者相同的人排在他前面。 编号为 1 的人身高为 7 ,没有身高更高或者相同的人排在他前面。 编号为 2 的人身高为 5 ,有 2 个身高更高或者相同的人排在他前面,即编号为 0 和 1 的人。 编号为 3 的人身高为 6 ,有 1 个身高更高或者相同的人排在他前面,即编号为 1 的人。 编号为 4 的人身高为 4 ,有 4 个身高更高或者相同的人排在他前面,即编号为 0、1、2、3 的人。 编号为 5 的人身高为 7 ,有 1 个身高更高或者相同的人排在他前面,即编号为 1 的人。 因此 [[5,0],[7,0],[5,2],[6,1],[4,4],[7,1]] 是重新构造后的队列。
解题思路
 public int[][] reconstructQueue(int[][] people) {
        if (people==null||people[0]==null) {
            return null;
        }
        //按照身高从大到小排列,身高相同,k从小到大排列
        //排序前:[[7,0],[4,4],[7,1],[5,0],[6,1],[5,2]]
        //排序后:[[7,0],[7,1],[6,1],[5,2],[5,0],[4,4]]
        Arrays.sort(people, new Comparator<int[]>() {
            @Override
            public int compare(int[] o1, int[] o2) {
               // return o1[0] != o2[0] ? o1[0]-o2[0] : o2[1] - o1[1];
                return o1[0] == o2[0] ? o1[1] - o2[1] : o2[0] - o1[0];
            }
        });
        List<int[]> list = new ArrayList<>(people.length);
        for (int[] i : people) {
            list.add(i[1],i);
        }
        return list.toArray(new int[list.size()][2]);
    }
第538题-把二叉搜索树转换为累加树
给出二叉 搜索 树的根节点,该树的节点值各不相同,请你将其转换为累加树(Greater Sum Tree),使每个节点 node 的新值等于原树中大于或等于 node.val 的值之和。
提醒一下,二叉搜索树满足下列约束条件:
节点的左子树仅包含键 小于 节点键的节点。 节点的右子树仅包含键 大于 节点键的节点。 左右子树也必须是二叉搜索树。 注意:本题和 1038: https://leetcode-cn.com/problems/binary-search-tree-to-greater-sum-tree/ 相同

示例 1:
输入:[4,1,6,0,2,5,7,null,null,null,3,null,null,null,8] 输出:[30,36,21,36,35,26,15,null,null,null,33,null,null,null,8]
解题思路
这个题其实就是对二叉树按照右子树-根节点+左子树的顺序进行遍历,并且记录之前遍历的节点的和,然后当前节点值=之前的节点和+当前值
		int sum = 0;
    public TreeNode convertBST(TreeNode root) {
        if (root==null) return null;
        convertBST(root.right);
        sum +=root.val;
        root.val = sum;
        convertBST(root.left);
        return root;
    }
第297题-二叉树的序列化与反序列化
序列化是将一个数据结构或者对象转换为连续的比特位的操作,进而可以将转换后的数据存储在一个文件或者内存中,同时也可以通过网络传输到另一个计算机环境,采取相反方式重构得到原数据。
请设计一个算法来实现二叉树的序列化与反序列化。这里不限定你的序列 / 反序列化算法执行逻辑,你只需要保证一个二叉树可以被序列化为一个字符串并且将这个字符串反序列化为原始的树结构。
示例:
你可以将以下二叉树:
1
/
2 3
/
4 5
序列化为 "[1,2,3,null,null,4,5]" 提示: 这与 LeetCode 目前使用的方式一致,详情请参阅 LeetCode 序列化二叉树的格式。你并非必须采取这种方式,你也可以采用其他的方法解决这个问题。
说明: 不要使用类的成员 / 全局 / 静态变量来存储状态,你的序列化和反序列化算法应该是无状态的。
解题思路
    String serialize(TreeNode root) {
        StringBuffer stringBuffer = new StringBuffer();
        if (root == null) {return stringBuffer.toString();}
        ArrayList<TreeNode> queue = new ArrayList<TreeNode>();
        queue.add(root);
        while (queue.size()>0) {
            TreeNode node = queue.remove(0);
            if (node == null) {
                stringBuffer.append("#!");
            } else {
                stringBuffer.append(node.val+"!");
                queue.add(node.left);
                queue.add(node.right);
            }
        }
        return stringBuffer.toString();
}

TreeNode deserialize(String str) {
        if (str == null || str.length() == 0) {return null;}
        String[] array = str.split("!");

        Integer rootValue = convert(array[0]);
        if (rootValue == null) {return null;}

        TreeNode rootNode = new TreeNode(rootValue);
        ArrayList<TreeNode> queue = new ArrayList<TreeNode>();
        queue.add(rootNode);
        int currentIndex = 1;
        while (queue.size()>0 && currentIndex<array.length) {
            TreeNode node = queue.remove(0);
            Integer leftValue,rightValue;
            leftValue = convert(array[currentIndex]);
            rightValue = convert(array[currentIndex+1]);
            currentIndex = currentIndex + 2;
            if (leftValue!=null) {
                TreeNode leftNode = new TreeNode(leftValue);
                node.left = leftNode;
                queue.add(leftNode);
            }
            if (rightValue!=null) {
                TreeNode rightNode = new TreeNode(rightValue);
                node.right = rightNode;
                queue.add(rightNode);
            }
        }

        return rootNode;
}

    Integer convert(String str) {
        Integer result;
        try {
            result = Integer.parseInt(str);
        } catch (NumberFormatException e) {
            return null;
        }
        return result;
}
第438题-找到字符串中所有字母异位词
给定一个字符串 s 和一个非空字符串 p,找到 s 中所有是 p 的字母异位词的子串,返回这些子串的起始索引。
字符串只包含小写英文字母,并且字符串 s 和 p 的长度都不超过 20100。
说明:
字母异位词指字母相同,但排列不同的字符串。 不考虑答案输出的顺序。 示例 1:
输入: s: "cbaebabacd" p: "abc"
输出: [0, 6]
解释: 起始索引等于 0 的子串是 "cba", 它是 "abc" 的字母异位词。 起始索引等于 6 的子串是 "bac", 它是 "abc" 的字母异位词。
解题思路
跟76题 最小覆盖子串那个题很像,其实也是通过滑动窗口来查找,只是说这里判断子串是否是目标串的异位词,会需要借助额外的辅助结构,就是试用一个needMap来记录目标串中出现的字符和次数。然后遍历字符串,进行窗口右移,在windowsMap中对这个字符的出现次数+1,判断右边的这个字符是否是需要的字符,是需要的就对valid_num+1,然后判断窗口大小如果<目标串长度就继续遍历。等于目标串大小时就判断当前valid_num是否等于目标串长度,等于就说明是异位词,然后窗口左边界移动。
public List<Integer> findAnagrams(String s, String p) {
        List<Integer> list = new ArrayList<>();
        if (s==null||p==null) {
            return list;
        }
        HashMap<Character,Integer> needMap = new HashMap<>();
        for (int i = 0; i < p.length(); i++) {
            Character c = p.charAt(i);
            Integer times = needMap.get(c);
            times = times == null ? 1 : times + 1;
            needMap.put(c,times);
        }
        int left=0;
        int right =0;
        int valid_num = 0;
        HashMap<Character,Integer> windowsMap = new HashMap<>();
        while (left<=right && right<s.length()) {
            Character c = s.charAt(right);
            //需要才会添加
            if (needMap.containsKey(c)) {
                Integer times = windowsMap.get(c);
                times = times == null ? 1:times+1;
                windowsMap.put(c,times);
                if (times<=needMap.get(c)) {//说明是现在需要的,并不是多余的
                    valid_num++;
                }
            }
            int currentWindowSize = right - left+1;
            if (currentWindowSize < p.length()) {
                right++;
                continue;
            } else if (currentWindowSize == p.length()) {
                if (valid_num==p.length()) {//说明满足需求
                    list.add(left);
                }
                //窗口左边界移动一个字符
                Character leftChar = s.charAt(left);
                if (needMap.containsKey(leftChar)) {
                    //移除一个左边界字符
                    Integer times = windowsMap.get(leftChar);
                    times--;
                    windowsMap.put(leftChar,times);
                    //如果移除后,字符不够了,就对valid_num-1
                    if (times<needMap.get(leftChar)) {
                        valid_num--;
                    }
                }
                left++;
                right++;
            }
        }
        return list;
    }
第240题-搜索二维矩阵II
编写一个高效的算法来搜索 m x n 矩阵 matrix 中的一个目标值 target 。该矩阵具有以下特性:
每行的元素从左到右升序排列。 每列的元素从上到下升序排列。
示例 1:

输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 5 输出:true 示例 2:
输入:matrix = [[1,4,7,11,15],[2,5,8,12,19],[3,6,9,16,22],[10,13,14,17,24],[18,21,23,26,30]], target = 20 输出:false
解题思路
就是从二维矩阵右上角开始出发,拿当值与目标值比较:
1.等于目标值,说明存在,直接返回
2.当前值>目标值,需要排除更大的数,由于这一列都是比目标值大的,都需要排除掉。
3.当前值<目标值,需要排除更小的数,由于这一行都是比目标值小的,都需要排除掉。
public boolean searchMatrix(int[][] matrix, int target) {
        if (matrix==null||matrix[0]==null) {
            return false;
        }
        int rowength = matrix.length;
        int colLength = matrix[0].length;
        int i = 0,j = colLength-1;
        while (i < rowength && j >=0) {
            if (matrix[i][j] == target) {
                return true;
            } else if (matrix[i][j] > target) {//当前值>目标值,需要排除更大的数
                j--;//排除这一列
            } else if (matrix[i][j] < target) {//当前值<目标值,需要排除更小的数
                i++;//排除这一行
            }
        }
        return false;
    }
第494题-目标和
给定一个非负整数数组,a1, a2, ..., an, 和一个目标数,S。现在你有两个符号 + 和 -。对于数组中的任意一个整数,你都可以从 + 或 -中选择一个符号添加在前面。
返回可以使最终数组和为目标数 S 的所有添加符号的方法数。 示例:
输入:nums: [1, 1, 1, 1, 1], S: 3 输出:5 解释:
-1+1+1+1+1 = 3 +1-1+1+1+1 = 3 +1+1-1+1+1 = 3 +1+1+1-1+1 = 3 +1+1+1+1-1 = 3
一共有5种方法让最终目标和为3。
解题思路
假设前面添加+的数组成的子数组为x,前面加-的数组成的子数组为y, 那么
x+y=sum //sum为数组之和
x-y=S
所以x= (sum+S)/2,所以问题变成了从数组中选取一些数,它们的和的为(sum+S)/2,所以转换为01背包问题了,变成从n个物品中取x个物品,正好价值等于某个数。
		int result =0;
    public int findTargetSumWays(int[] nums, int S) {
        if (nums==null||nums.length==0) {return 0;}
        int sum=0;
        for (int i = 0; i < nums.length; i++) {
            sum+=nums[i];
        }
        if ((sum + S)%2==1) {//是奇数,不可能有结果
            return 0;
        }
        findTargetSumWays(nums,(sum+S)/2,nums.length-1);
        return result;
    }
    public void findTargetSumWays(int[] nums, int sum,int i) {
        if (sum<0) {
            return;
        }
        //到最后一个元素了,不能继续递归选择了
        if (i==0) {
            //如果等于sum,那么选择元素i,将result+1,
            //如果sum为0,那么不选择元素i,将result+1
            if (nums[i] == sum) {
                result++;
            }
            if (sum==0) {
                result++;
            }
            return;
        }
        //不选这个元素
        findTargetSumWays(nums,sum,i-1);
        //选这个元素
        findTargetSumWays(nums,sum-nums[i],i-1);
    }
第621题-任务调度器
给你一个用字符数组 tasks 表示的 CPU 需要执行的任务列表。其中每个字母表示一种不同种类的任务。任务可以以任意顺序执行,并且每个任务都可以在 1 个单位时间内执行完。在任何一个单位时间,CPU 可以完成一个任务,或者处于待命状态。
然而,两个 相同种类 的任务之间必须有长度为整数 n 的冷却时间,因此至少有连续 n 个单位时间内 CPU 在执行不同的任务,或者在待命状态。
你需要计算完成所有任务所需要的 最短时间 。 示例 1:
输入:tasks = ["A","A","A","B","B","B"], n = 2 输出:8 解释:A -> B -> (待命) -> A -> B -> (待命) -> A -> B 在本示例中,两个相同类型任务之间必须间隔长度为 n = 2 的冷却时间,而执行一个任务只需要一个单位时间,所以中间出现了(待命)状态。
解题思路
假设没有某个时间点需要待命,那么任务所需要的最短时间就是任务的总数量,就是tasks.length。如果有某个时间点需要待命,那么一定是出现次数最多的那种任务导致的,此时就根据次数最多的任务来计算最大值。 当没有时间需要待命时, 最短时间=tasks.length 需要待命时,出现次数最多的那种任务只有1种时, 最短时间=(maxCount-1)(n+1)+1 需要待命时,出现次数最多的那种任务有x种时, 最短时间=(maxCount-1)(n+1)+x
public int leastInterval(char[] tasks, int n) {
        int[] count = new int[26];
        for (int i = 0; i < tasks.length; i++) {
            int index = tasks[i] - 'A';
            count[index]++;
        }
        //找出频率最大的字符
        int maxCount=0;
        //频率最大的字符有几个
        int times=0;
        for (int i = 0; i < count.length; i++) {
            if (count[i] > maxCount) {
                maxCount = count[i];
                times=1;
            } else if(count[i] == maxCount) {
                times++;
            }
        }
        int max = (maxCount-1)*(n+1) + 1 + times - 1;
        max = max > tasks.length ? max : tasks.length;
        return max;
    }
第581题-最短无序连续子数组
给定一个整数数组,你需要寻找一个连续的子数组,如果对这个子数组进行升序排序,那么整个数组都会变为升序排序。
你找到的子数组应是最短的,请输出它的长度。
示例 1:
输入: [2, 6, 4, 8, 10, 9, 15] 输出: 5 解释: 你只需要对 [6, 4, 8, 10, 9] 进行升序排序,那么整个表都会变为升序排序。 说明 :
输入的数组长度范围在 [1, 10,000]。 输入的数组可能包含重复元素 ,所以升序的意思是<=。
解题思路
这个题就是寻找逆序对,找出需要最左边的需要调整的逆序对位置,然后再找出最右边的逆序对位置,两者之间的距离就是子数组的长度。
public int findUnsortedSubarray(int[] nums) {
        if (nums==null||nums.length==0) {
            return 0;
        }
        //从左往右开始遍历,记录最大值,找到需要调整的最右边的位置的下标
        Integer right = null;
        int maxIndex = 0;
        for (int i = 0; i < nums.length; i++) {
            if (nums[i] < nums[maxIndex]) {//说明是需要调整的
                right=i;
            }
            maxIndex = nums[i] > nums[maxIndex] ? i : maxIndex;
        }
        //从右往左开始遍历,记录最小值,找到需要调整的最右边的位置的下标
        Integer left = null;
        int minIndex = nums.length-1;
        for (int i = nums.length-1; i >=0; i--) {
            if (nums[i] > nums[minIndex]) {//说明是需要调整的
                left=i;
            }
            minIndex = nums[i] < nums[minIndex] ? i : minIndex;
        }
        if (left!=null&& right!=null) {
            return right-left+1;
        }
        return 0;
    }