README.es.md
September 13, 2026 · View on GitHub
LWC — Memoria proactiva para agentes de IA
Dirigido por agentes · Persistente · Basado en fuentes




English · 简体中文 · 日本語 · Español · Português (Brasil) · Français · Русский
lwc es una CLI de memoria proactiva, dirigida por agentes y pensada para agentes de IA. Permite que recuperen, mantengan y hagan evolucionar por sí mismos conocimiento persistente y trazable hasta sus fuentes entre una sesión y la siguiente.
Funciona con Claude Code, Codex, Cursor, OpenCode, Gemini CLI, Kiro, Hermes, Antigravity, GitHub Copilot in VS Code, Copilot CLI, Copilot for JetBrains y pi.
LWC convierte documentos seleccionados en una Wiki duradera. El agente razona y sintetiza; lwc conserva fuentes, páginas, citas, enlaces, índices e historial para que el conocimiento se acumule, en vez de reconstruirse desde fragmentos sin procesar en cada consulta.
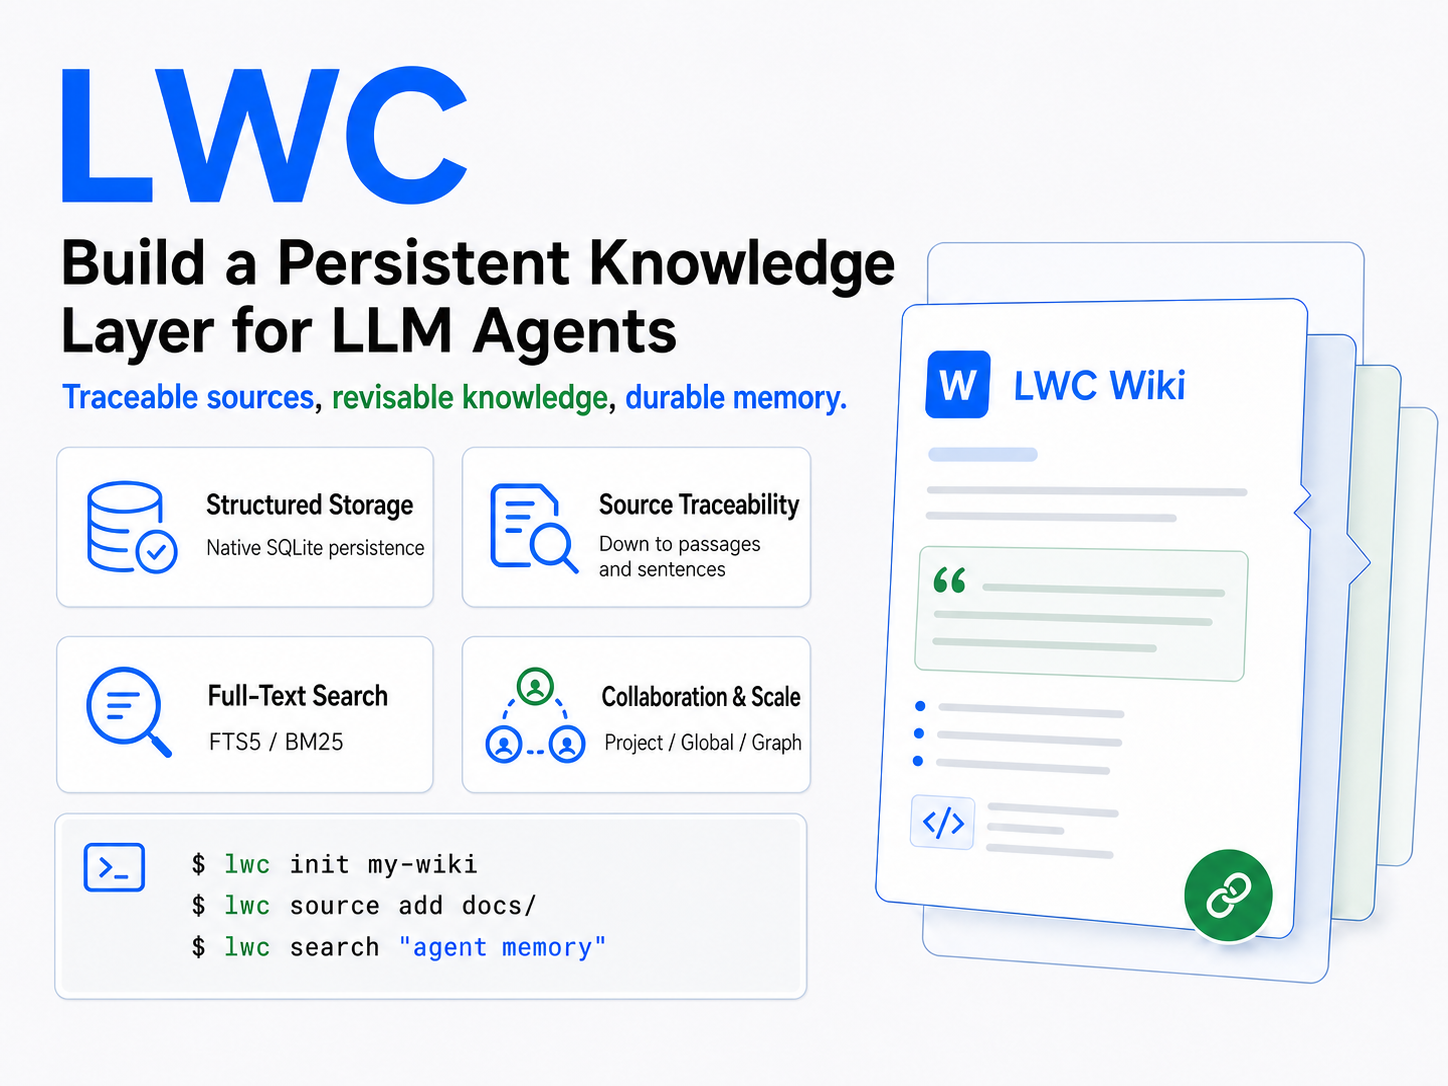
LWC es memoria para agentes, no RAG
RAG y LWC pueden ayudar a un LLM a trabajar con documentos externos, pero conservan el estado en lugares distintos. Una petición RAG típica recupera fragmentos sin procesar y genera una respuesta puntual:
query -> retrieve chunks -> generate answer
LWC conserva el trabajo útil entre peticiones:
task -> recall maintained Wiki -> reason from sources and prior synthesis
     -> write durable improvements back
La recuperación es una operación de LWC, no su principio organizador. El artefacto duradero es una Wiki basada en fuentes cuyas páginas, citas, enlaces, contradicciones e historial se revisan a medida que cambia el conocimiento. Por eso LWC no necesita embeddings ni una base de datos vectorial, y tampoco desecha cada síntesis al terminar una respuesta. Puede complementar a RAG, pero no es RAG ejecutado en cada consulta.
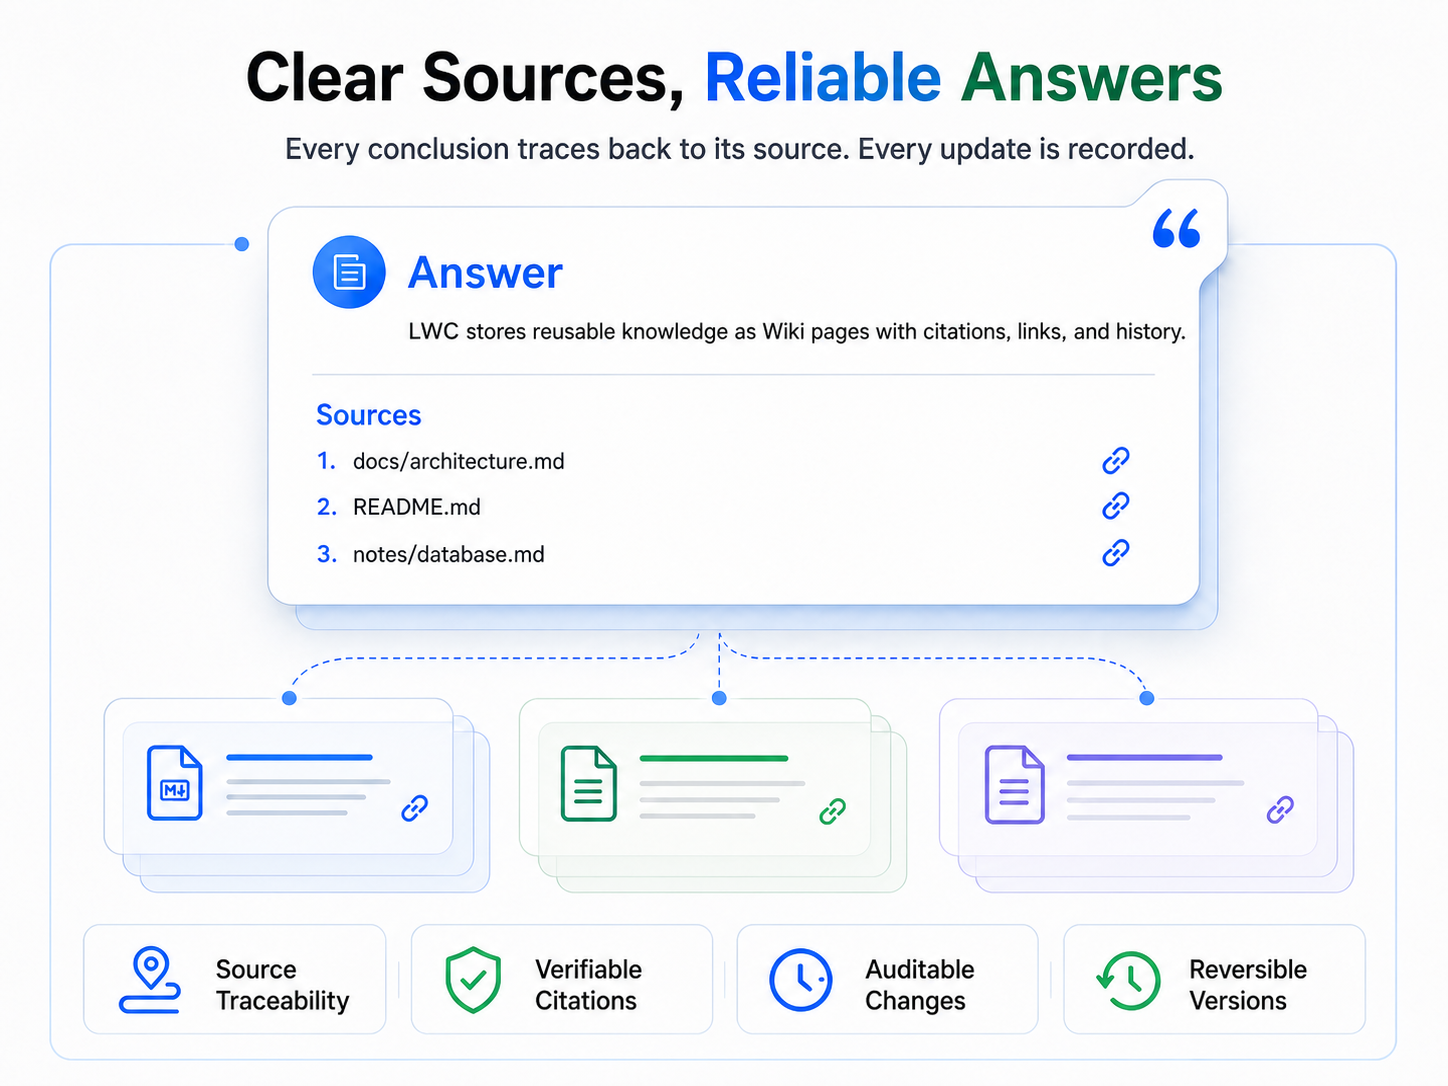
El agente opera LWC
lwc es una interfaz de máquina para agentes, no una aplicación de notas orientada a personas. En el uso normal, una persona selecciona fuentes, fija objetivos, plantea preguntas y revisa las respuestas o el Markdown proyectado. El agente ejecuta la CLI, gestiona los ámbitos, integra fuentes, mantiene citas y enlaces y decide qué merece recuperarse o escribirse de vuelta.
No dirijas manualmente el flujo habitual de lwc salvo que estés desarrollando o depurando la herramienta. Pide a tu agente que active el Skill canónico using-lwc, normalmente mediante $using-lwc.
Recomendado: pide a tu agente que configure LWC
Pega este prompt en el agente que utilizas. Instala la CLI global, delega toda configuración de hosts compatibles al instalador idempotente AgentTarget de LWC y solo recurre a la configuración nativa cuando el agente aún no está registrado.
Copiar el prompt de configuración completo
Configura LWC por completo para este usuario. Ejecuta y verifica el trabajo; no te
limites a describir los comandos que debo ejecutar.

Fuentes de referencia:
- https://github.com/JanYork/llm-wiki-cli
- https://github.com/JanYork/llm-wiki-cli/tree/main/skills/using-lwc

Requisitos:
1. Lee este README, `SECURITY.md` y `skills/using-lwc/SKILL.md`. Si `lwc` no se
   puede invocar globalmente, instala la versión oficial verificada por checksum;
   no antepongas una ruta privada al binario ni `LWC_PROJECT_ROOT` a los comandos
   habituales.
2. Ejecuta `lwc --version`; si falta la memoria global, inicialízala una sola vez
   con `lwc --scope global init`; después ejecuta `lwc agent install --yes`. Ese
   comando detecta los agentes compatibles instalados e instala de forma segura
   su MCP, Skill, Hook e Instructions en las ubicaciones oficiales. No reproduzcas
   esa lógica manualmente ni instales además un paquete nativo para el mismo agente.
3. Revisa `lwc agent status --target all --location global`. Reinicia los agentes
   afectados y completa la revisión de confianza habitual para los Hooks cuando
   corresponda. No inicialices una Wiki de proyecto ni ninguno de los grafos sin
   consentimiento explícito para ese proyecto.
4. Si el entorno de ejecución actual no es uno de los AgentTargets registrados por LWC, usa sus
   convenciones oficiales de usuario para instalar el Skill canónico `using-lwc`,
   un bloque de instrucciones aditivo, `lwc serve --mcp` y un Hook de sesión acotado,
   solo donde esos puntos de integración tengan soporte oficial. Conserva la configuración
   existente, mantén la idempotencia e informa de los puntos no compatibles
   en lugar de inventar rutas o claves.

Al terminar, informa de la versión de LWC, los Targets detectados y configurados,
los resultados de status, los archivos modificados, los puntos de integración no compatibles
y cualquier reinicio o acción de confianza que quede pendiente.
Origen y agradecimientos
lwc implementa el patrón LLM Wiki propuesto por Andrej Karpathy: un LLM construye y mantiene de forma incremental una Wiki persistente e interconectada, en lugar de reconstruir el conocimiento desde documentos sin procesar en cada consulta. La arquitectura de la CLI y algunos detalles de implementación también se inspiran en nashsu/llm_wiki.
Este proyecto adapta esas ideas a una CLI en Rust, orientada primero a agentes y respaldada por SQLite.
Diseño fundamental
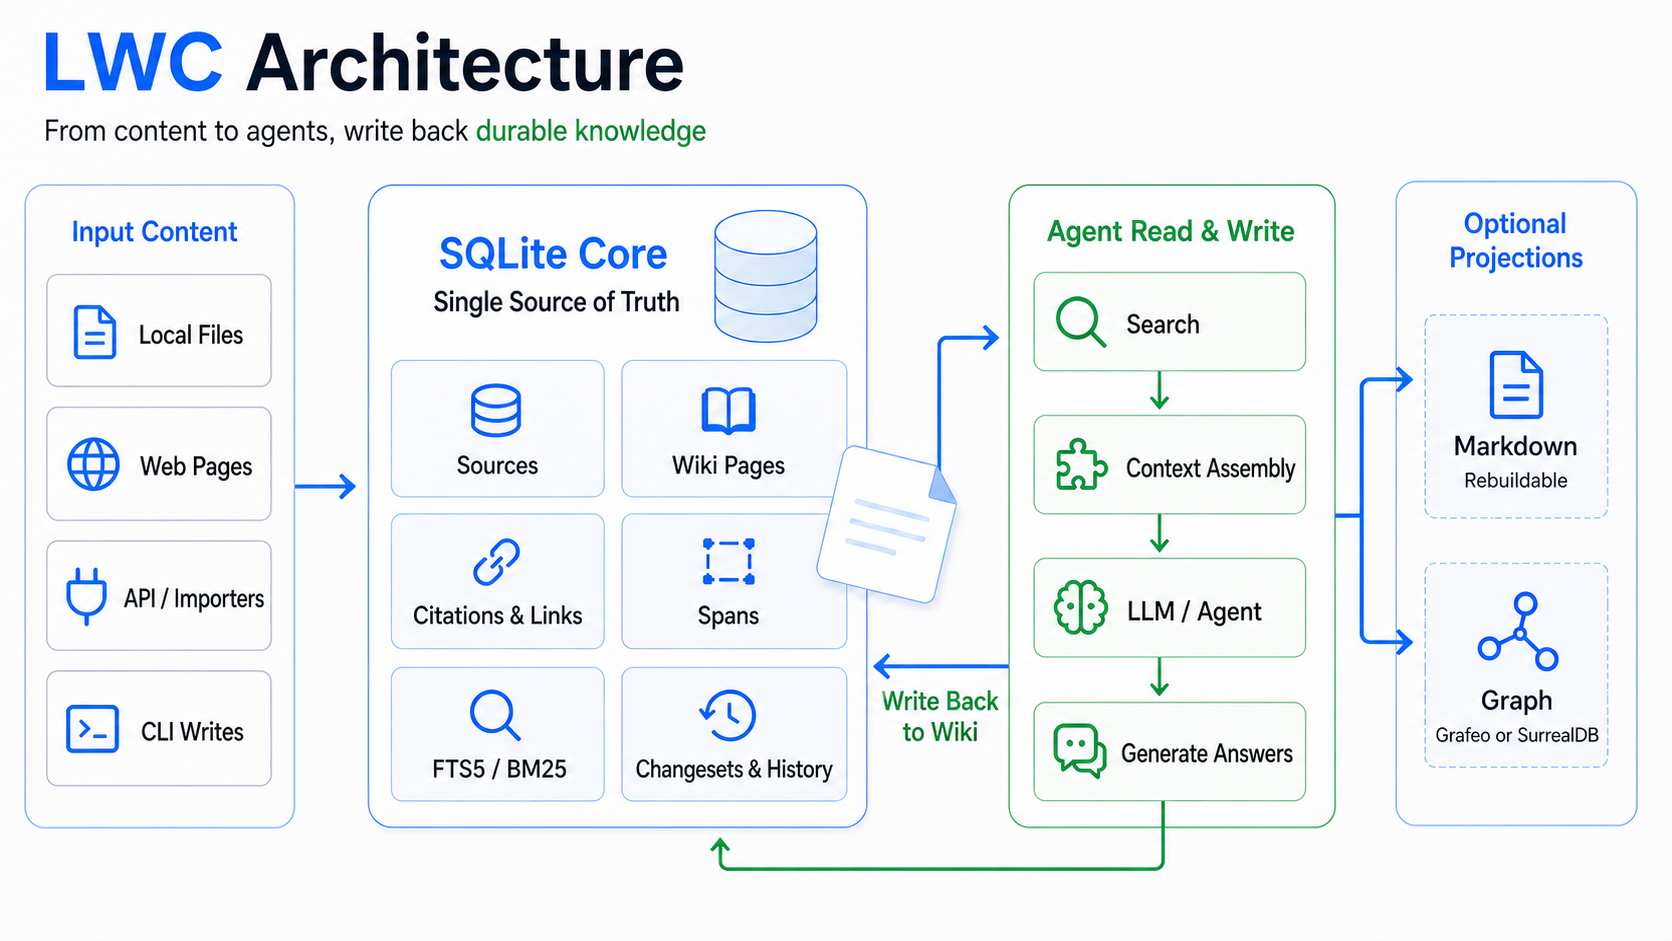
LWC separa el conocimiento duradero en capas claramente delimitadas:
| Capa | Finalidad |
|---|---|
| Fuentes originales | Instantáneas inmutables de evidencia seleccionada |
| Wiki | Páginas, citas, enlaces y procedencia mantenidos por el agente |
| Esquema y propósito | Reglas del proyecto que guían el mantenimiento futuro |
SQLite es la fuente de verdad. Markdown, los índices de texto completo y los grafos opcionales son proyecciones reconstruibles. Las operaciones devuelven JSON estructurado para facilitar la auditoría y la recuperación.
Recuperación jerárquica y grafo de conocimiento
LWC indexa las fuentes y las páginas de la Wiki a nivel de documento, pasaje y oración. El agente puede empezar con un contexto pequeño y relevante y ampliar solo el fragmento exacto que necesita.
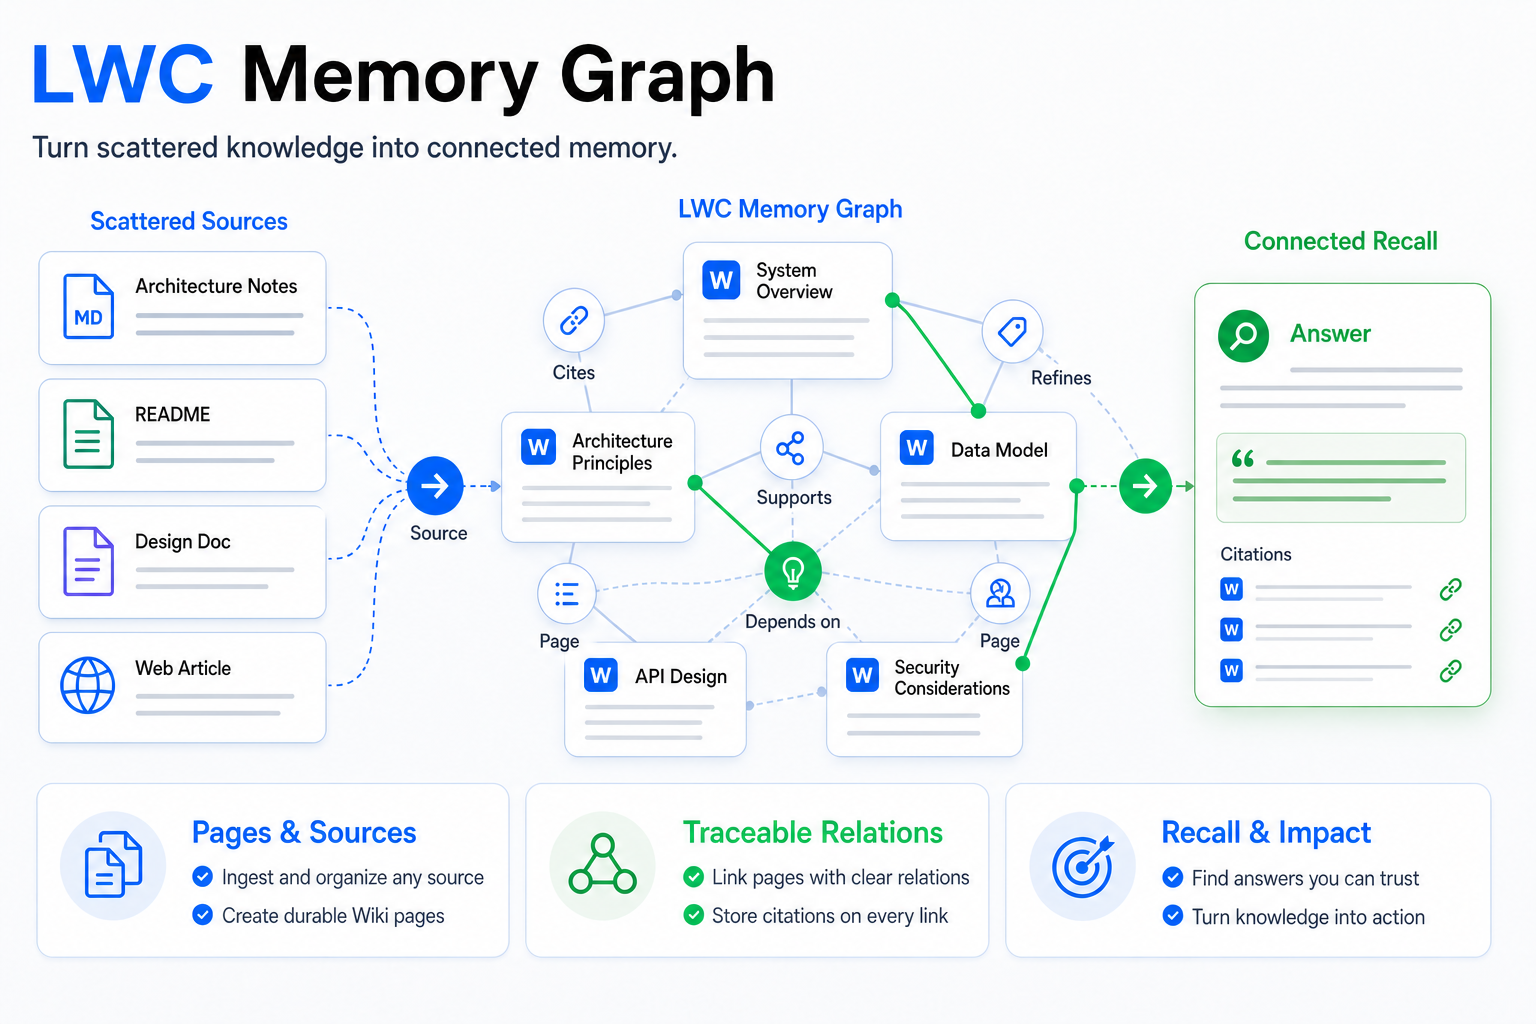
El grafo documental opcional conecta páginas, fuentes, citas, enlaces y relaciones semánticas explícitas. SQLite sigue siendo la autoridad; Grafeo o SurrealDB aportan una capa de recorrido reconstruible. Cada relación conserva su motivo, procedencia, confianza y evidencia.
Conversión de documentos y lectura de Office
Los adaptadores opcionales Anydoc o MarkItDown convierten archivos locales compatibles en Markdown revisable antes de incorporarlos. OfficeCLI ofrece una vía separada, de solo lectura y sujeta a consentimiento para Word, Excel y PowerPoint. Ninguna capacidad se instala ni activa en silencio, y los archivos de Office originales no se modifican.
Recuperación e indexación → · Grafo documental → · Conversión de documentos →
Instalación
Para la mayoría de los usuarios basta con un comando:
npm install --global @i-xor/lwc
También se admiten Homebrew, crates.io, las versiones de GitHub verificadas mediante suma de comprobación y las compilaciones locales con Cargo.
Instalación y actualizaciones →
Skill complementario para agentes
El Skill using-lwc incluido convierte LWC en una capa de memoria proactiva. Recupera contexto acotado, separa el conocimiento de proyecto del global, integra fuentes, mantiene las citas y solo conserva conocimiento verificado que merece reutilizarse.
Se instala desde skills.sh:
npx skills add JanYork/llm-wiki-cli --skill using-lwc -g
La invocación canónica es $using-lwc. El Skill es independiente
del agente e incluye guías específicas para memoria, grafos documentales, Word
Graph, CodeGraph, etiquetas fuertes, conversión, configuración, recuperación y
mantenimiento.
Configuración nativa de agentes
LWC detecta los agentes compatibles y configura sus superficies MCP, Skill, Hook e Instructions mediante adaptadores AgentTarget idempotentes:
lwc agent install --yes
El MCP unificado y de solo lectura ofrece memoria Wiki acotada y contexto de código opcional sin ampliar el espacio de trabajo. Es compatible con Claude Code, Codex, Cursor, OpenCode, Gemini CLI, Kiro, Hermes, Antigravity, GitHub Copilot in VS Code, Copilot CLI, Copilot for JetBrains y pi.
Inicio rápido
Normalmente, la persona describe el objetivo y revisa el resultado; el agente maneja la CLI. El recorrido completo está en la guía de inicio rápido.
1. Inicializar una Wiki de proyecto
El agente crea una Wiki local del proyecto y define su propósito y reglas de mantenimiento. El estado se excluye localmente de Git salvo que se decida versionarlo de forma explícita.
2. Añadir material fuente
Los archivos seleccionados se convierten en instantáneas inmutables y sin duplicados. LWC rastrea sus rutas y puede indicar si el archivo actual no ha cambiado, se ha modificado, falta o ha sido reemplazado.
3. Analizar e integrar una fuente
El agente lee la fuente completa dentro de límites explícitos, escribe un resumen con citas, actualiza el conocimiento compartido y solo entonces da por terminada la incorporación.
4. Consultar la Wiki acumulada
La búsqueda prioriza las páginas mantenidas sin perder el vínculo con la evidencia. El agente abre el texto original exacto cuando una afirmación exige verificación.
Flujo de trabajo del agente
El ciclo normal consiste en recuperar conocimiento relevante, comprobar fuentes o código actuales cuando importa la vigencia, realizar la mínima actualización verificada y validar la recuperación, los enlaces y los grafos aplicables. Las revisiones amplias se publican de forma atómica mediante un changeset.
Cambios atómicos con varios comandos
Un changeset mantiene oculta una actualización de varios pasos hasta que haya sido revisada y validada. El commit publica en una sola transacción únicamente las entidades afectadas, conserva el trabajo ajeno y falla de forma segura ante un conflicto de revisión de la misma entidad.
Para las operaciones compatibles se conserva un parche inverso exacto, lo que permite un rollback protegido sin reemplazar toda la Wiki.
Ámbitos
| Ámbito | Uso |
|---|---|
| project | Conocimiento perteneciente a la Wiki del proyecto más cercano |
| global | Conocimiento reutilizable entre proyectos |
| all | Recuperación combinada de solo lectura y Sync coordinado |
Las escrituras siempre apuntan a un único almacén explícito; LWC no crea citas ni enlaces implícitos entre proyectos.
Ámbitos y detección de proyectos →
Búsqueda y CJK
La búsqueda es léxica, determinista y prioriza las páginas mantenidas. Puntúa por separado título, ruta, resumen, cuerpo, procedencia y evidencia del grafo; admite filtros de página, fuente y tipo, y puede explicar el cálculo exacto.
Para CJK usa bigramas adyacentes y unigramas útiles; para texto latino, términos alfanuméricos en minúsculas. Al no depender de diccionarios, mantiene un comportamiento estable con nombres de productos, símbolos de código, texto multilingüe y vocabulario emergente.
Pesos y feedback explícitos
Los pesos auditables expresan la importancia duradera de un documento. El feedback de una consulta solo reordena candidatos coincidentes y guarda una huella, no la consulta original. Ninguno puede hacer aparecer contenido ajeno.
Visor de solo lectura y CodeGraph
El visor local presenta páginas, fuentes, Markdown, relaciones documentales y estructura del código mediante una interfaz de bucle local limitada a GET/HEAD. No migra, actualiza ni construye grafos.
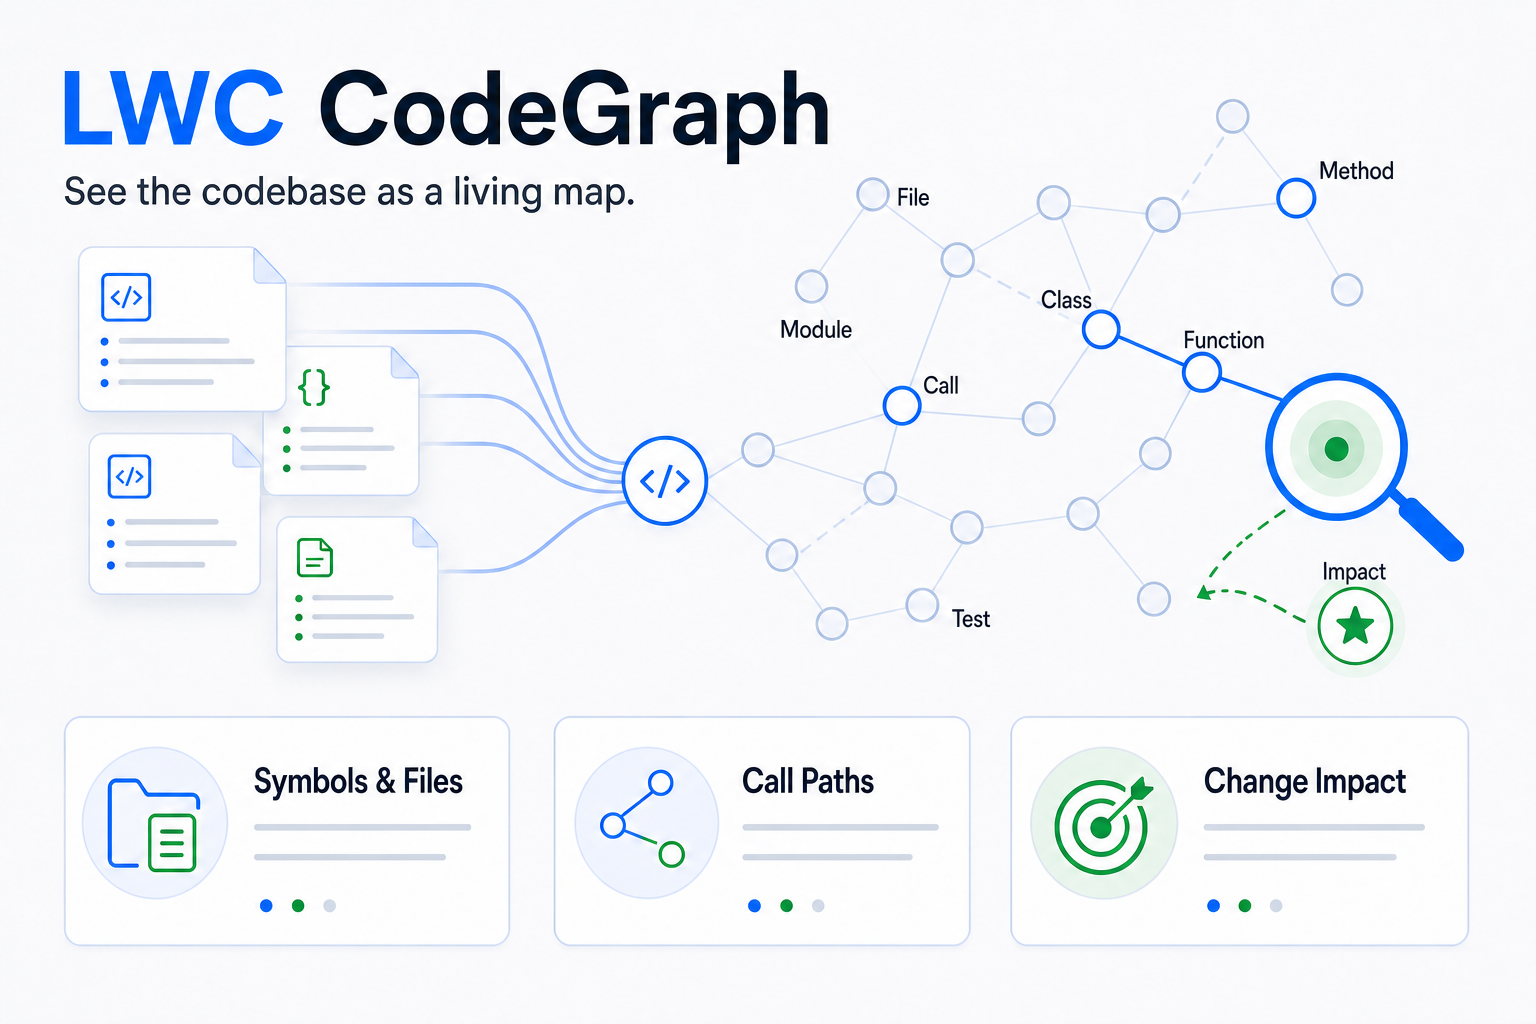
CodeGraph es exclusivo del proyecto y se inicializa de forma explícita. Permite consultar símbolos, llamadores, llamados, dependencias, archivos e impacto, mantiene la telemetría desactivada y actualiza el grafo de forma atómica por archivo propietario.
El runtime reconoce TypeScript, TSX, JavaScript, JSX, ArkTS, Python, Go, Rust, Java, C, C++, C#, Razor, PHP, Ruby, Swift, Kotlin, Dart, Svelte, Vue, Astro, Liquid, Pascal, Scala, Lua, Luau, Objective-C, R, Solidity, Nix, YAML, Twig, XML, .properties, CFML, CFScript, CFQuery, COBOL, VB.NET, Erlang y Terraform.
Mantenimiento y proyección
El lint, la reindexación, la materialización de Markdown, la compactación, los checkpoints y la proyección de grafos son operaciones explícitas. El trabajo largo es duradero, observable, reanudable y se aplica por unidades documentales acotadas.
SQLite sigue siendo la autoridad. Los índices, Markdown y grafos pueden reconstruirse sin reescribir la historia de las fuentes ni el conocimiento actual de la Wiki.
Suite de benchmarks
El benchmark opcional mide tiempo de importación, latencia de búsqueda, Recall@5/10, MRR y almacenamiento sobre un corpus saneado aportado por el usuario. Una comparación justa fija máquina, corpus, consultas y condiciones, y compara medianas de varias ejecuciones.
Resultados LongMemEval-S (v0.18.5)
Esta es una referencia sin ajuste, no el límite del rendimiento de LWC durante el uso continuado. El modelo puede evaluar pruebas de forma proactiva y responder a correcciones del usuario o comentarios de relevancia, actualizando pesos y feedback por consulta. Con feedback fiable y ajustes sostenidos, cabe esperar mejores resultados que esta referencia estática; esa mejora adicional no se ha cuantificado. El ajuste reactivo lo ejecuta el Agent en respuesta al feedback, no un aprendizaje automático con cada búsqueda.
Dos ejecuciones locales del 13 de septiembre de 2026: 500/500 preguntas, 470 puntuadas para recuperación, conjunto de datos fijado y 4 trabajadores concurrentes en un Mac Apple M5 Pro. La segunda reutilizó las fuentes; las 500 listas ordenadas fueron idénticas.
| Métrica | Primera | Segunda |
|---|---|---|
| Preguntas procesadas | 500 / 500 | 500 / 500 |
| Preguntas puntuadas | 470 | 470 |
| Preguntas de abstención excluidas | 30 | 30 |
| Recall@1 | 83.83% (394/470) | 83.83% (394/470) |
| Recall@3 | 91.49% (430/470) | 91.49% (430/470) |
| Recall@5 | 95.11% (447/470) | 95.11% (447/470) |
| Recall@10 | 97.66% (459/470) | 97.66% (459/470) |
| Recall@30 | 99.15% (466/470) | 99.15% (466/470) |
| Recall@50 | 99.15% (466/470) | 99.15% (466/470) |
| MRR | 0.883668 | 0.883668 |
| Latencia media | 509.883 ms | 679.759 ms |
| P50 | 507.697 ms | 665.454 ms |
| P90 | 663.061 ms | 931.238 ms |
| P95 | 731.766 ms | 990.375 ms |
| P99 | 888.555 ms | 1094.886 ms |
Estos resultados no incluyen ajuste proactivo. El adaptador solo recupera fuentes de sesiones; no incluye curación por el modelo, comentarios de relevancia ni cambios de peso. Durante el uso, el modelo puede evaluar evidencia y ajustar explícitamente pesos o comentarios por consulta para mejorar la recuperación. No ocurre automáticamente en cada búsqueda; depende de la calidad del feedback y aquí no se midió su beneficio. Evaluar los ajustes con preguntas reservadas, sin reutilizar las respuestas de prueba. Son resultados locales de recuperación, no una clasificación oficial ni exactitud de respuestas. Las latencias reflejan carga de cuatro trabajadores, no una comparación controlada de velocidad entre versiones.
Datos: 1 · Datos: 2 · LongMemEval-S
Límites y objetivos excluidos
Restricciones actuales:
- base de conocimiento para una sola máquina y un solo usuario;
- flujo de texto UTF-8;
- límite de 64 MiB por schema, purpose, source o cuerpo de página;
- búsqueda léxica, no recuperación vectorial semántica.
Objetivos excluidos deliberadamente:
- sin llamadas LLM incorporadas;
- sin base de datos vectorial;
- sin daemon ni servicio en segundo plano;
- sin interfaz web ni de escritorio;
- sin contrato para editar directamente la base de datos.
Si la proyección Markdown se desvía, reconstrúyela. Si el esquema SQLite está mal, corrígelo mediante la CLI y migraciones, no a mano.
Contribuir
Se aceptan issues y pull requests, especialmente sobre:
- ergonomía del flujo de agentes;
- proyección determinista;
- contratos duraderos de citas y mantenimiento de páginas;
- calidad de búsqueda en corpus técnicos multilingües.
Lee CONTRIBUTING.md antes de abrir un pull request. Informa de problemas de seguridad según SECURITY.md.
Licencia
Publicado bajo la Apache License 2.0.