VideoX-Fun
April 16, 2026 · View on GitHub
😊 ようこそ!
CogVideoX-Fun:
Wan-Fun:
目次
紹介
VideoX-Funはビデオ生成のパイプラインであり、AI画像やビデオの生成、Diffusion TransformerのベースラインモデルとLoraモデルのトレーニングに使用できます。我々は、すでに学習済みのベースラインモデルから直接予測を行い、異なる解像度、秒数、FPSのビデオを生成することをサポートしています。また、ユーザーが独自のベースラインモデルやLoraモデルをトレーニングし、特定のスタイル変換を行うこともサポートしています。
異なるプラットフォームからのクイックスタートをサポートします。詳細はクイックスタートを参照してください。
新機能:
- Wan 2.2シリーズモデル、Wan-VACE制御モデル、Fantasy Talkingデジタルヒューマンモデル、Qwen-Image、Flux画像生成モデルなどのサポートを追加しました。[2025.10.16]
- Wan2.1-Fun-V1.1バージョンを更新:14Bと1.3BモデルのControl+参照画像モデルをサポート、カメラ制御にも対応。さらに、Inpaintモデルを再訓練し、性能が向上しました。[2025.04.25]
- Wan2.1-Fun-V1.0の更新:14Bおよび1.3BのI2V(画像からビデオ)モデルとControlモデルをサポートし、開始フレームと終了フレームの予測に対応。[2025.03.26]
- CogVideoX-Fun-V1.5の更新:I2Vモデルと関連するトレーニング・予測コードをアップロード。[2024.12.16]
- 報酬Loraのサポート:報酬逆伝播技術を使用してLoraをトレーニングし、生成された動画を最適化し、人間の好みによりよく一致させる。詳細情報。新しいバージョンの制御モデルでは、Canny、Depth、Pose、MLSDなどの異なる制御条件に対応。[2024.11.21]
- diffusersのサポート:CogVideoX-Fun Controlがdiffusersでサポートされるようになりました。a-r-r-o-wがこのPRでサポートを提供してくれたことに感謝します。詳細はドキュメントをご覧ください。[2024.10.16]
- CogVideoX-Fun-V1.1の更新:i2vモデルを再トレーニングし、Noiseを追加して動画の動きの範囲を拡大。制御モデルのトレーニングコードとControlモデルをアップロード。[2024.09.29]
- CogVideoX-Fun-V1.0の更新:コードを作成!WindowsとLinuxに対応しました。2Bおよび5Bモデルでの最大256x256x49から1024x1024x49までの任意の解像度の動画生成をサポート。[2024.09.18]
機能:
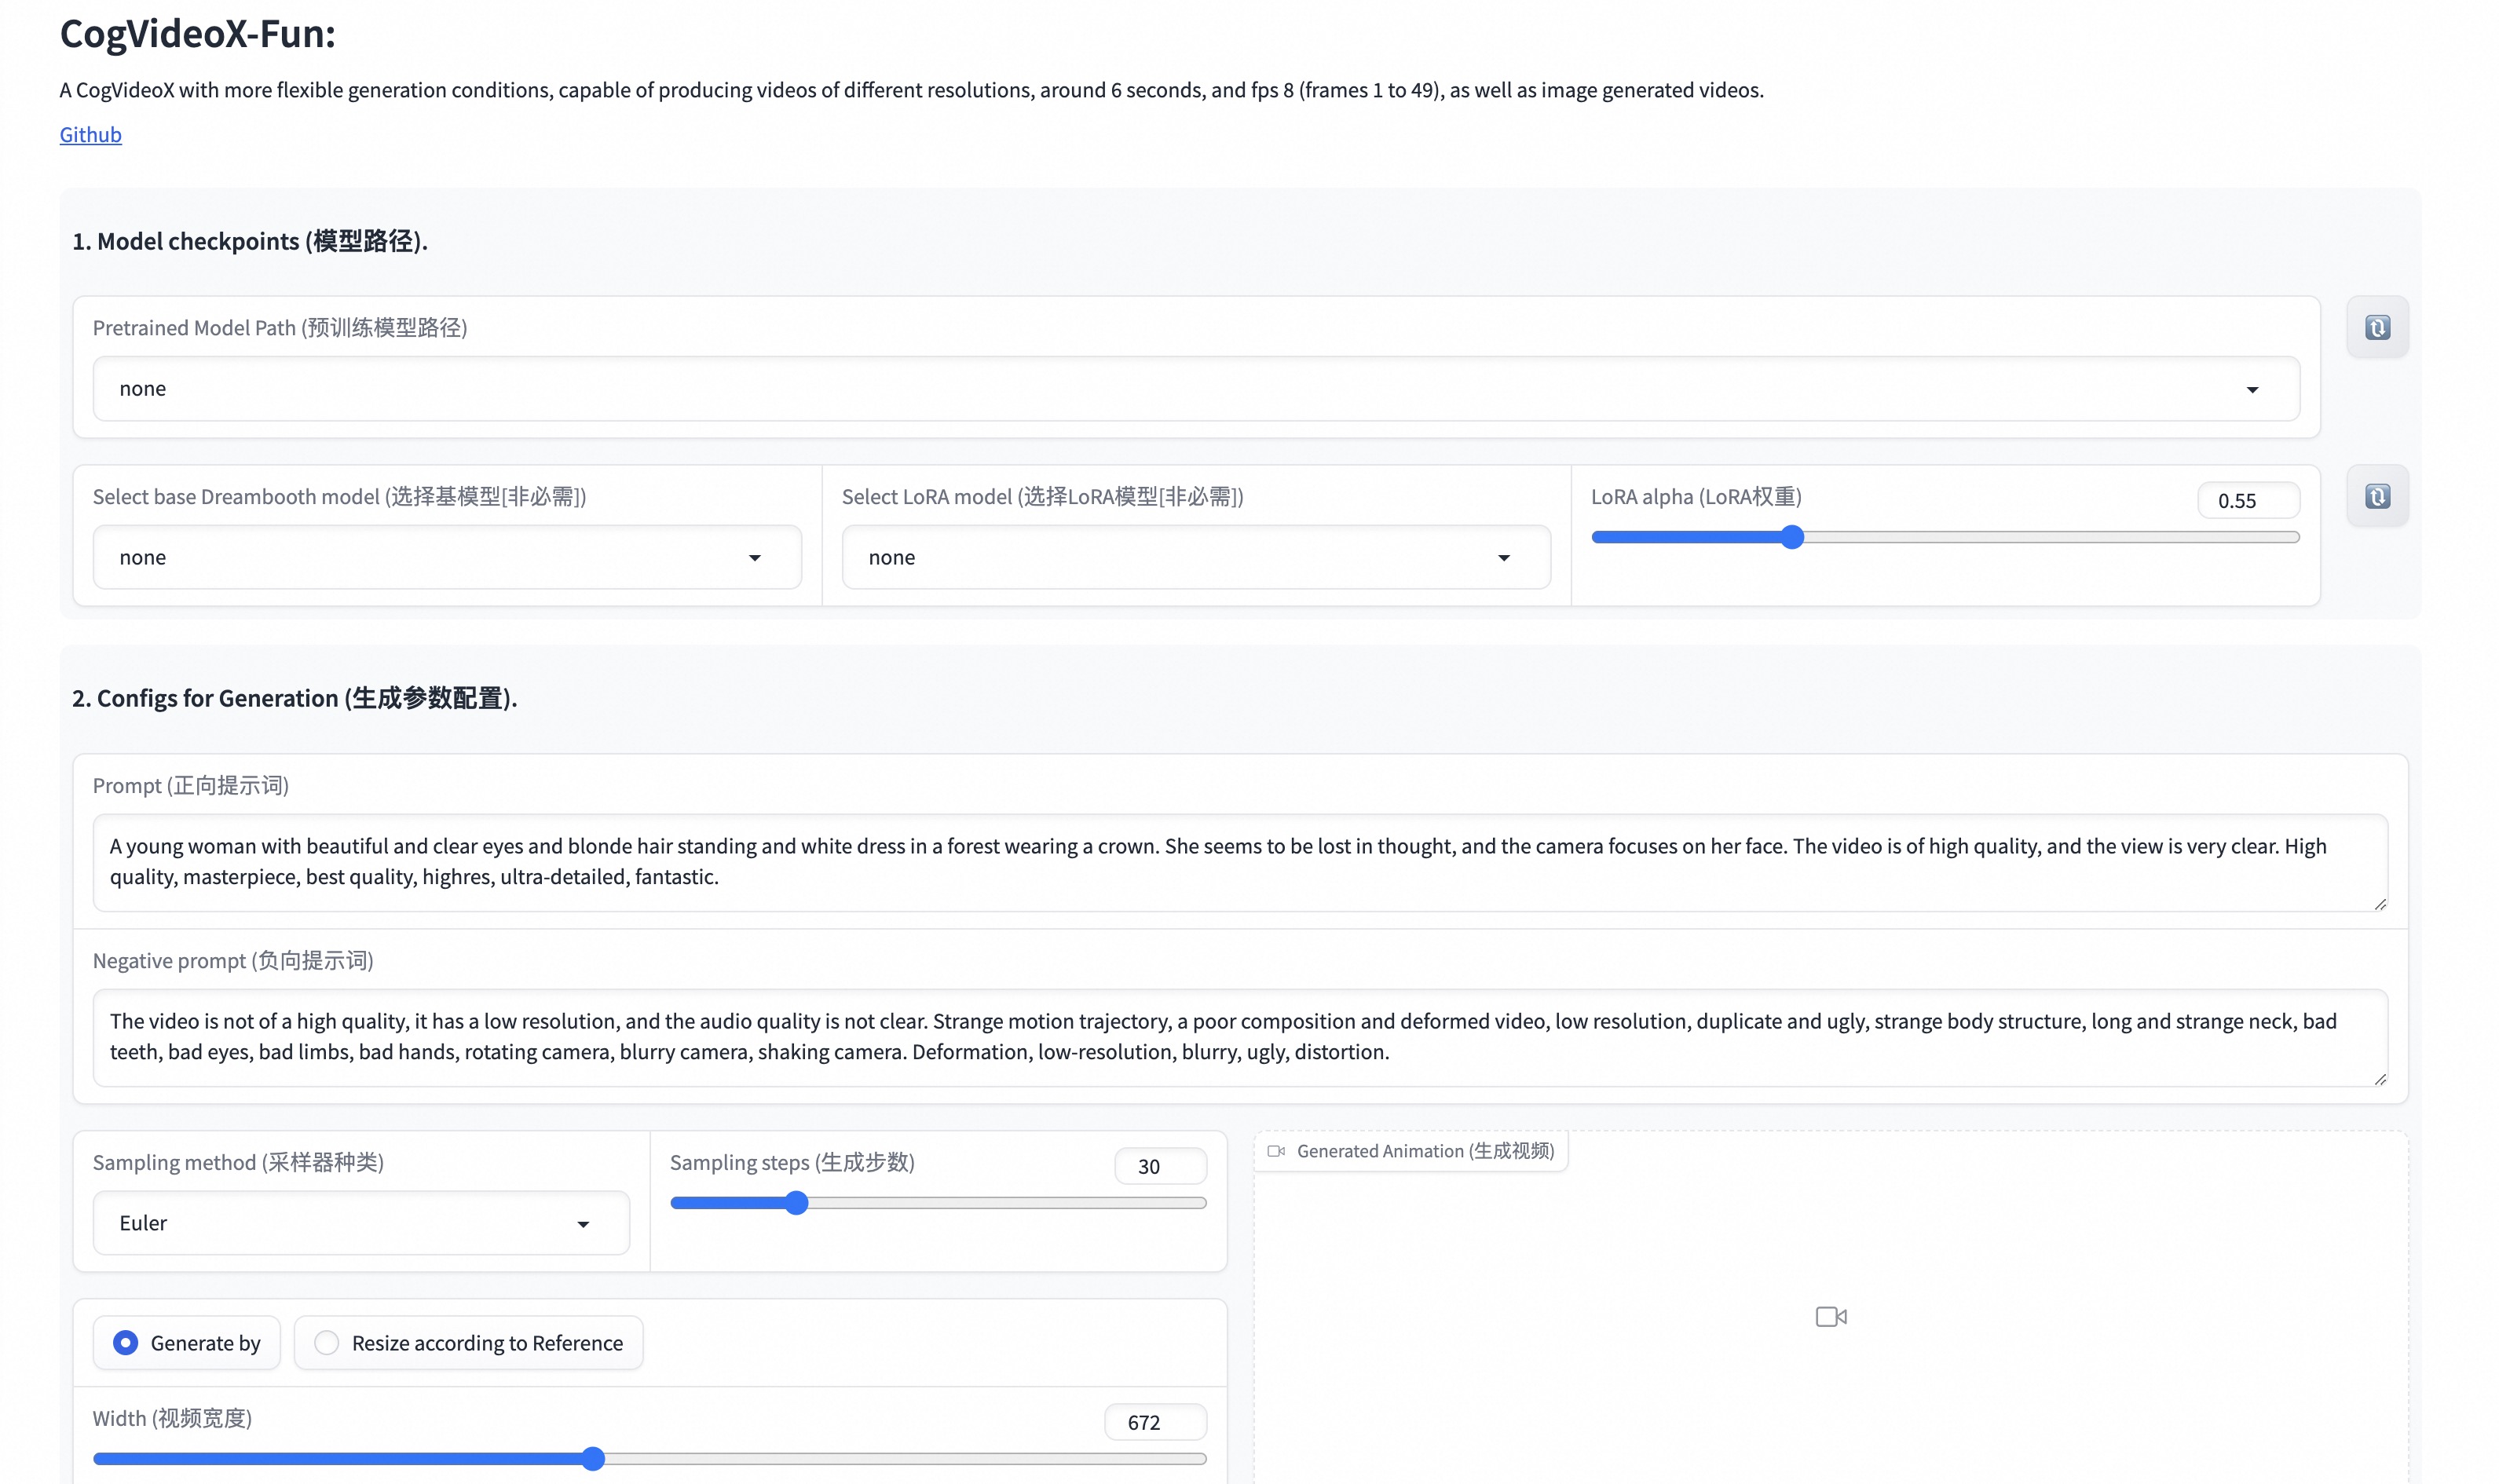
私たちのUIインターフェースは次のとおりです:
クイックスタート
1. クラウド使用: AliyunDSW/Docker
a. AliyunDSWから
DSWには無料のGPU時間があり、ユーザーは一度申請でき、申請後3か月間有効です。
AliyunはFreetierで無料のGPU時間を提供しています。取得してAliyun PAI-DSWで使用し、5分以内にCogVideoX-Funを開始できます!
b. ComfyUIから
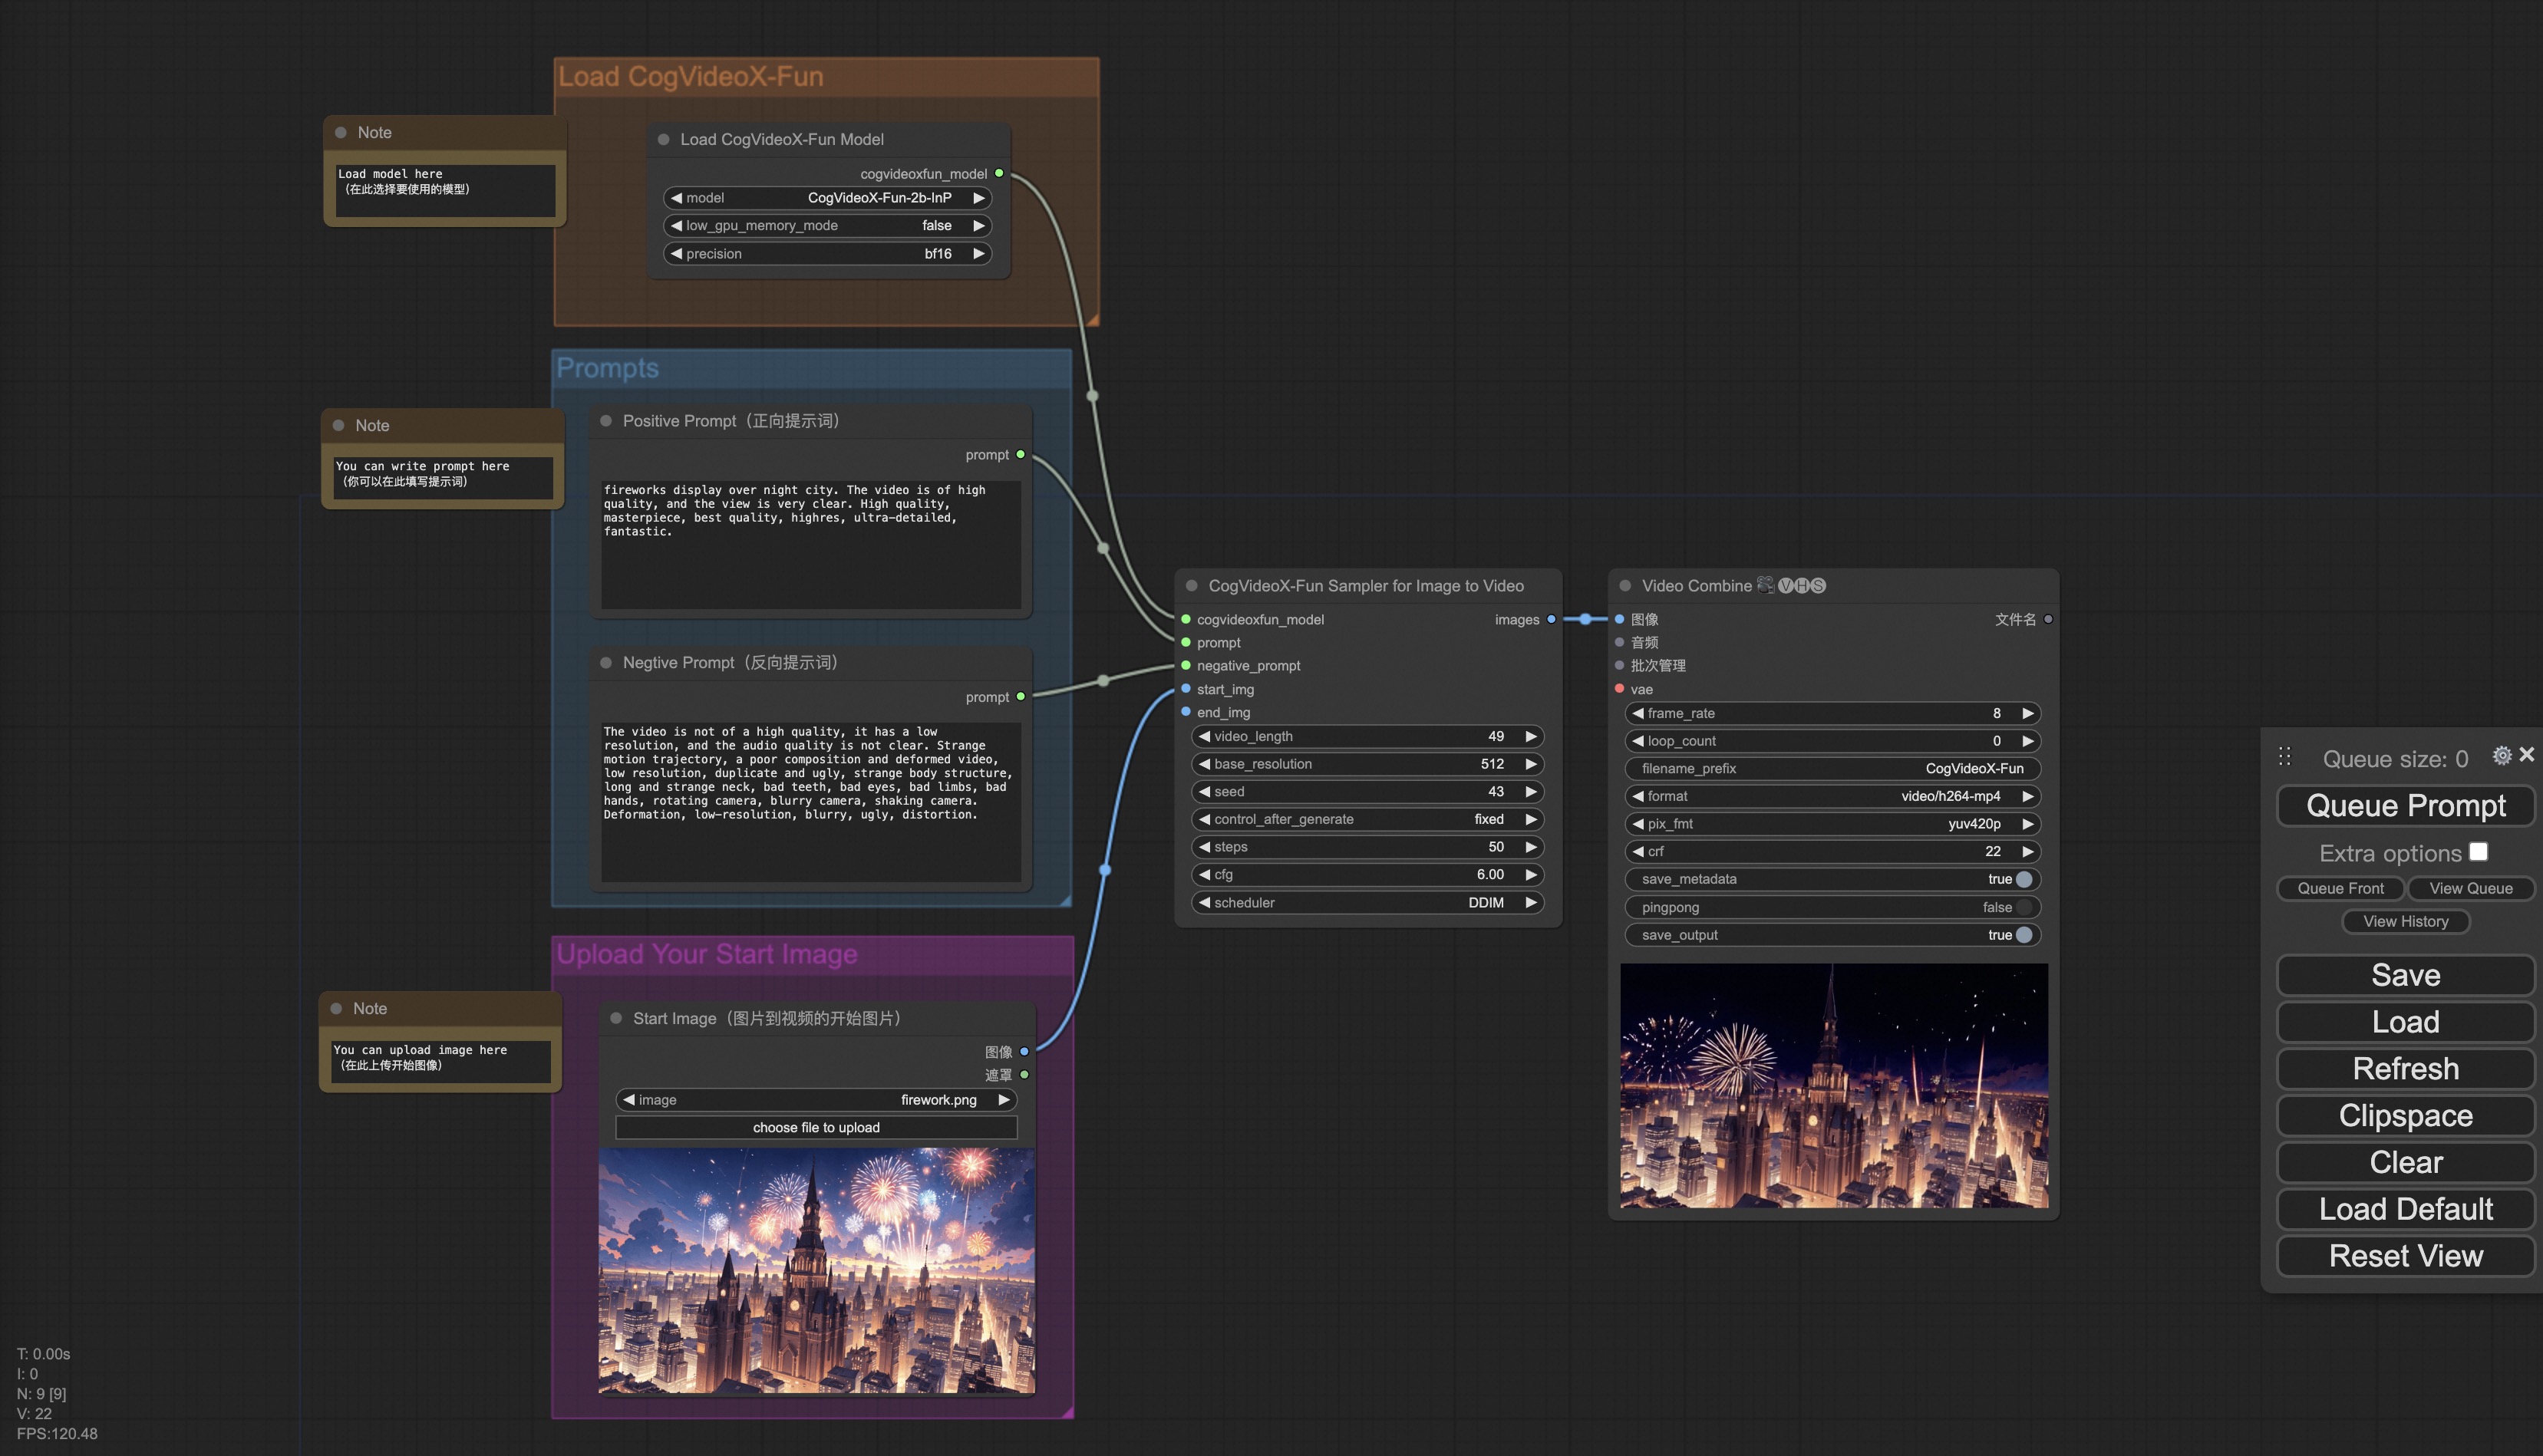
私たちのComfyUIは次のとおりです。詳細はComfyUI READMEを参照してください。
c. Dockerから
Dockerを使用する場合、マシンにグラフィックスカードドライバとCUDA環境が正しくインストールされていることを確認してください。
次のコマンドをこの方法で実行します:
# イメージをプル
docker pull mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# イメージに入る
docker run -it -p 7860:7860 --network host --gpus all --security-opt seccomp:unconfined --shm-size 200g mybigpai-public-registry.cn-beijing.cr.aliyuncs.com/easycv/torch_cuda:cogvideox_fun

# コードをクローン
git clone https://github.com/aigc-apps/VideoX-Fun.git

# VideoX-Funのディレクトリに入る
cd VideoX-Fun

# 重みをダウンロード
mkdir models/Diffusion_Transformer
mkdir models/Personalized_Model

# Please use the hugginface link or modelscope link to download the model.
# CogVideoX-Fun
# https://huggingface.co/alibaba-pai/CogVideoX-Fun-V1.1-5b-InP
# https://modelscope.cn/models/PAI/CogVideoX-Fun-V1.1-5b-InP

# Wan
# https://huggingface.co/alibaba-pai/Wan2.1-Fun-V1.1-14B-InP
# https://modelscope.cn/models/PAI/Wan2.1-Fun-V1.1-14B-InP
2. ローカルインストール: 環境チェック/ダウンロード/インストール
a. 環境チェック
以下の環境でこのライブラリの実行を確認しています:
Windowsの詳細:
- OS: Windows 10
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU: Nvidia-3060 12G & Nvidia-3090 24G
Linuxの詳細:
- OS: Ubuntu 20.04, CentOS
- python: python3.10 & python3.11
- pytorch: torch2.2.0
- CUDA: 11.8 & 12.1
- CUDNN: 8+
- GPU:Nvidia-V100 16G & Nvidia-A10 24G & Nvidia-A100 40G & Nvidia-A100 80G
重みを保存するために約60GBのディスクスペースが必要です。確認してください!
b. 重み
重みを指定されたパスに配置することをお勧めします:
ComfyUIを通じて:
モデルをComfyUIの重みフォルダ ComfyUI/models/Fun_Models/ に入れます:
📦 ComfyUI/
├── 📂 models/
│   └── 📂 Fun_Models/
│       ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
│       ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
│       ├── 📂 Wan2.1-Fun-V1.1-14B-InP
│       └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
独自のpythonファイルまたはUIインターフェースを実行:
📦 models/
├── 📂 Diffusion_Transformer/
│   ├── 📂 CogVideoX-Fun-V1.1-2b-InP/
│   ├── 📂 CogVideoX-Fun-V1.1-5b-InP/
│   ├── 📂 Wan2.1-Fun-V1.1-14B-InP
│   └── 📂 Wan2.1-Fun-V1.1-1.3B-InP/
├── 📂 Personalized_Model/
│   └── あなたのトレーニング済みのトランスフォーマーモデル / あなたのトレーニング済みのLoraモデル(UIロード用)
ビデオ結果
Wan2.1-Fun-V1.1-14B-InP && Wan2.1-Fun-V1.1-1.3B-InP
Wan2.1-Fun-V1.1-14B-Control && Wan2.1-Fun-V1.1-1.3B-Control
Generic Control Video + Reference Image:
| Reference Image | Control Video | Wan2.1-Fun-V1.1-14B-Control | Wan2.1-Fun-V1.1-1.3B-Control |
|
|
|||
Generic Control Video (Canny, Pose, Depth, etc.) and Trajectory Control:
Wan2.1-Fun-V1.1-14B-Control-Camera && Wan2.1-Fun-V1.1-1.3B-Control-Camera
| Pan Up | Pan Left | Pan Right |
| Pan Down | Pan Up + Pan Left | Pan Up + Pan Right |
CogVideoX-Fun-V1.1-5B
解像度-1024
解像度-768
解像度-512
CogVideoX-Fun-V1.1-5B-Control
| 美しい澄んだ目と金髪の若い女性が白い服を着て体をひねり、カメラは彼女の顔に焦点を合わせています。高品質、傑作、最高品質、高解像度、超微細、夢のような。 | 美しい澄んだ目と金髪の若い女性が白い服を着て体をひねり、カメラは彼女の顔に焦点を合わせています。高品質、傑作、最高品質、高解像度、超微細、夢のような。 | 若いクマ。 |
使い方
1. 生成
a. GPUメモリ節約方法
Wan2.1のパラメータが非常に大きいため、GPUメモリを節約し、コンシューマー向けGPUに適応させる必要があります。各予測ファイルにはGPU_memory_modeを提供しており、model_cpu_offload、model_cpu_offload_and_qfloat8、sequential_cpu_offloadの中から選択できます。この方法はCogVideoX-Funの生成にも適用されます。
model_cpu_offload: モデル全体が使用後にCPUに移動し、一部のGPUメモリを節約します。model_cpu_offload_and_qfloat8: モデル全体が使用後にCPUに移動し、Transformerモデルに対してfloat8の量子化を行い、より多くのGPUメモリを節約します。sequential_cpu_offload: モデルの各層が使用後にCPUに移動します。速度は遅くなりますが、大量のGPUメモリを節約します。
qfloat8はモデルの性能を部分的に低下させる可能性がありますが、より多くのGPUメモリを節約できます。十分なGPUメモリがある場合は、model_cpu_offloadの使用をお勧めします。
b. ComfyUIを使用する
詳細はComfyUI READMEをご覧ください。
c. Pythonファイルを実行する
i. 単一GPUでの推論:
- ステップ1: 対応する重みをダウンロードし、
modelsフォルダに配置します。 - ステップ2: 異なる重みと予測目標に基づいて、異なるファイルを使用して予測を行います。現在、このライブラリはCogVideoX-Fun、Wan2.1、およびWan2.1-Funをサポートしています。
examplesフォルダ内のフォルダ名で区別され、異なるモデルがサポートする機能が異なりますので、状況に応じて区別してください。以下はCogVideoX-Funを例として説明します。- テキストからビデオ:
examples/cogvideox_fun/predict_t2v.pyファイルでprompt、neg_prompt、guidance_scale、seedを変更します。- 次に、
examples/cogvideox_fun/predict_t2v.pyファイルを実行し、結果が生成されるのを待ちます。結果はsamples/cogvideox-fun-videosフォルダに保存されます。
- 画像からビデオ:
examples/cogvideox_fun/predict_i2v.pyファイルでvalidation_image_start、validation_image_end、prompt、neg_prompt、guidance_scale、seedを変更します。validation_image_startはビデオの開始画像、validation_image_endはビデオの終了画像です。- 次に、
examples/cogvideox_fun/predict_i2v.pyファイルを実行し、結果が生成されるのを待ちます。結果はsamples/cogvideox-fun-videos_i2vフォルダに保存されます。
- ビデオからビデオ:
examples/cogvideox_fun/predict_v2v.pyファイルでvalidation_video、validation_image_end、prompt、neg_prompt、guidance_scale、seedを変更します。validation_videoはビデオ生成のための参照ビデオです。以下のデモビデオを使用して実行できます:デモビデオ- 次に、
examples/cogvideox_fun/predict_v2v.pyファイルを実行し、結果が生成されるのを待ちます。結果はsamples/cogvideox-fun-videos_v2vフォルダに保存されます。
- 通常の制御付きビデオ生成(Canny、Pose、Depthなど):
examples/cogvideox_fun/predict_v2v_control.pyファイルでcontrol_video、validation_image_end、prompt、neg_prompt、guidance_scale、seedを変更します。control_videoは、Canny、Pose、Depthなどの演算子で抽出された制御用ビデオです。以下のデモビデオを使用して実行できます:デモビデオ- 次に、
examples/cogvideox_fun/predict_v2v_control.pyファイルを実行し、結果が生成されるのを待ちます。結果はsamples/cogvideox-fun-videos_v2v_controlフォルダに保存されます。
- テキストからビデオ:
- ステップ3: 自分でトレーニングした他のバックボーンやLoraを組み合わせたい場合は、必要に応じて
examples/{model_name}/predict_t2v.pyやexamples/{model_name}/predict_i2v.py、lora_pathを修正します。
ii. 複数GPUでの推論:
多カードでの推論を行う際は、xfuserリポジトリのインストールに注意してください。xfuser==0.4.2 と yunchang==0.6.2 のインストールが推奨されます。
pip install xfuser==0.4.2 --progress-bar off -i https://mirrors.aliyun.com/pypi/simple/
pip install yunchang==0.6.2 --progress-bar off -i https://mirrors.aliyun.com/pypi/simple/
ulysses_degree と ring_degree の積が使用する GPU 数と一致することを確認してください。たとえば、8つのGPUを使用する場合、ulysses_degree=2 と ring_degree=4、または ulysses_degree=4 と ring_degree=2 を設定することができます。
ulysses_degreeはヘッド(head)に分割した後の並列化を行います。ring_degreeはシーケンスに分割した後の並列化を行います。
ring_degree は ulysses_degree よりも通信コストが高いため、これらのパラメータを設定する際には、シーケンス長とモデルのヘッド数を考慮する必要があります。
8GPUでの並列推論を例に挙げます:
-
Wan2.1-Fun-V1.1-14B-InP はヘッド数が40あります。この場合、
ulysses_degreeは40で割り切れる値(例:2, 4, 8など)に設定する必要があります。したがって、8GPUを使用して並列推論を行う場合、ulysses_degree=8とring_degree=1を設定できます。 -
Wan2.1-Fun-V1.1-1.3B-InP はヘッド数が12あります。この場合、
ulysses_degreeは12で割り切れる値(例:2, 4など)に設定する必要があります。したがって、8GPUを使用して並列推論を行う場合、ulysses_degree=4とring_degree=2を設定できます。
パラメータの設定が完了したら、以下のコマンドで並列推論を実行してください:
torchrun --nproc-per-node=8 examples/wan2.1_fun/predict_t2v.py
d. UIインターフェースを使用する
WebUIは、テキストからビデオ、画像からビデオ、ビデオからビデオ、および通常の制御付きビデオ生成(Canny、Pose、Depthなど)をサポートします。現在、このライブラリはCogVideoX-Fun、Wan2.1、およびWan2.1-Funをサポートしており、examplesフォルダ内のフォルダ名で区別されています。異なるモデルがサポートする機能が異なるため、状況に応じて区別してください。以下はCogVideoX-Funを例として説明します。
- ステップ1: 対応する重みをダウンロードし、
modelsフォルダに配置します。 - ステップ2:
examples/cogvideox_fun/app.pyファイルを実行し、Gradioページに入ります。 - ステップ3: ページ上で生成モデルを選択し、
prompt、neg_prompt、guidance_scale、seedなどを入力し、「生成」をクリックして結果が生成されるのを待ちます。結果はsampleフォルダに保存されます。
2. モデルのトレーニング
完全なモデルトレーニングの流れには、データの前処理とVideo DiTのトレーニングが含まれるべきです。異なるモデルのトレーニングプロセスは類似しており、データ形式も類似しています:
a. データ前処理
画像データを使用してLoraモデルをトレーニングする簡単なデモを提供しました。詳細はwikiをご覧ください。
長いビデオのセグメンテーション、クリーニング、説明のための完全なデータ前処理リンクは、ビデオキャプションセクションのREADMEを参照してください。
テキストから画像およびビデオ生成モデルをトレーニングしたい場合。この形式でデータセットを配置する必要があります。
📦 project/
├── 📂 datasets/
│   ├── 📂 internal_datasets/
│       ├── 📂 train/
│       │   ├── 📄 00000001.mp4
│       │   ├── 📄 00000002.jpg
│       │   └── 📄 .....
│       └── 📄 json_of_internal_datasets.json
json_of_internal_datasets.jsonは標準のJSONファイルです。json内のfile_pathは相対パスとして設定できます。以下のように:
[
    {
      "file_path": "train/00000001.mp4",
      "text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
      "type": "video"
    },
    {
      "file_path": "train/00000002.jpg",
      "text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
      "type": "image"
    },
    .....
]
次のように絶対パスとして設定することもできます:
[
    {
      "file_path": "/mnt/data/videos/00000001.mp4",
      "text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
      "type": "video"
    },
    {
      "file_path": "/mnt/data/train/00000001.jpg",
      "text": "スーツとサングラスを着た若い男性のグループが街の通りを歩いている。",
      "type": "image"
    },
    .....
]
b. Video DiTトレーニング
データ前処理時にデータ形式が相対パスの場合、scripts/{model_name}/train.shを次のように設定します。
export DATASET_NAME="datasets/internal_datasets/"
export DATASET_META_NAME="datasets/internal_datasets/json_of_internal_datasets.json"
データ形式が絶対パスの場合、scripts/train.shを次のように設定します。
export DATASET_NAME=""
export DATASET_META_NAME="/mnt/data/json_of_internal_datasets.json"
次に、scripts/train.shを実行します。
sh scripts/train.sh
いくつかのパラメータ設定の詳細について: Wan2.1-FunはReadme TrainとReadme Loraを参照してください。 Wan2.1はReadme TrainとReadme Loraを参照してください。 CogVideoX-FunはReadme TrainとReadme Loraを参照してください。
モデルの場所
1. Wan2.2-Fun
| 名前 | ストレージ容量 | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Wan2.2-Fun-A14B-InP | 64.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-14Bのテキスト・画像から動画を生成するモデルの重み。複数の解像度で学習されており、動画の最初と最後のフレームの予測をサポートしています。 |
| Wan2.2-Fun-A14B-Control | 64.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-14Bの動画制御用重み。Canny、Depth、Pose、MLSDなどのさまざまな制御条件に対応しており、軌跡制御もサポートしています。512、768、1024の複数解像度での動画生成が可能で、81フレーム、16fpsで学習されています。多言語対応の予測もサポートしています。 |
| Wan2.2-Fun-A14B-Contro-Camera | 64.0 GB | 🤗リンク | 😄リンク | Wan2.2-Fun-14Bのカメラレンズ制御重み。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
| Wan2.2-VACE-Fun-A14B | 64.0 GB | 🤗リンク | 😄リンク | VACE方式でトレーニングされたWan2.2の制御ウェイト(ベースモデルはWan2.2-T2V-A14B)。Canny、Depth、Pose、MLSD、軌道制御などの異なる制御条件をサポートします。対象を指定して動画生成が可能です。多解像度(512、768、1024)の動画予測をサポートし、81フレームで16FPSでトレーニングされています。多言語予測にも対応しています。 |
| Wan2.2-Fun-5B-InP | 23.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-5B テキストから動画生成用の重み。121フレーム、24 FPSで学習され、先頭/末尾フレーム予測をサポート。 |
| Wan2.2-Fun-5B-Control | 23.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-5B 動画制御用重み。Canny、Depth、Pose、MLSDなどの制御条件や軌道制御をサポート。121フレーム、24 FPSで学習され、多言語予測に対応。 |
| Wan2.2-Fun-5B-Control-Camera | 23.0 GB | 🤗Link | 😄Link | Wan2.2-Fun-5B カメラレンズ制御用重み。121フレーム、24 FPSで学習され、多言語予測に対応。 |
2. Wan2.2
| モデル名 | Hugging Face | Model Scope | 説明 |
|---|---|---|---|
| Wan2.2-TI2V-5B | 🤗リンク | 😄リンク | 万象2.2-5B テキストから動画生成重み |
| Wan2.2-T2V-A14B | 🤗リンク | 😄リンク | 万象2.2-14B テキストから動画生成重み |
| Wan2.2-I2V-A14B | 🤗リンク | 😄リンク | 万象2.2-14B 画像から動画生成重み |
3. Wan2.1-Fun
V1.1:
| 名称 | ストレージ容量 | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Wan2.1-Fun-V1.1-1.3B-InP | 19.0 GB | 🤗リンク | 😄リンク | Wan2.1-Fun-V1.1-1.3Bのテキスト・画像から動画生成の重み。マルチ解像度で訓練され、最初と最後の画像予測をサポートします。 |
| Wan2.1-Fun-V1.1-14B-InP | 47.0 GB | 🤗リンク | 😄リンク | Wan2.1-Fun-V1.1-14Bのテキスト・画像から動画生成の重み。マルチ解像度で訓練され、最初と最後の画像予測をサポートします。 |
| Wan2.1-Fun-V1.1-1.3B-Control | 19.0 GB | 🤗リンク | 😄リンク | Wan2.1-Fun-V1.1-1.3Bのビデオ制御重み。Canny、Depth、Pose、MLSDなどの異なる制御条件に対応し、参照画像+制御条件を使用した制御や軌跡制御をサポートします。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
| Wan2.1-Fun-V1.1-14B-Control | 47.0 GB | 🤗リンク | 😄リンク | Wan2.1-Fun-V1.1-14Bのビデオ制御重み。Canny、Depth、Pose、MLSDなどの異なる制御条件に対応し、参照画像+制御条件を使用した制御や軌跡制御をサポートします。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
| Wan2.1-Fun-V1.1-1.3B-Control-Camera | 19.0 GB | 🤗リンク | 😄リンク | Wan2.1-Fun-V1.1-1.3Bのカメラレンズ制御重み。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
| Wan2.1-Fun-V1.1-14B-Control-Camera | 47.0 GB | 🤗リンク | 😄リンク | Wan2.1-Fun-V1.1-14Bのカメラレンズ制御重み。512、768、1024のマルチ解像度での動画予測をサポートし、81フレーム、毎秒16フレームで訓練されています。多言語予測に対応しています。 |
V1.0:
| 名称 | ストレージ容量 | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Wan2.1-Fun-1.3B-InP | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-1.3Bのテキスト・画像から動画生成する重み。マルチ解像度で学習され、開始・終了画像予測をサポート。 |
| Wan2.1-Fun-14B-InP | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-14Bのテキスト・画像から動画生成する重み。マルチ解像度で学習され、開始・終了画像予測をサポート。 |
| Wan2.1-Fun-1.3B-Control | 19.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-1.3Bのビデオ制御ウェイト。Canny、Depth、Pose、MLSDなどの異なる制御条件をサポートし、トラジェクトリ制御も利用可能。512、768、1024のマルチ解像度でのビデオ予測をサポートし、81フレーム(1秒間に16フレーム)でトレーニング済みで、多言語予測にも対応しています。 |
| Wan2.1-Fun-14B-Control | 47.0 GB | 🤗Link | 😄Link | Wan2.1-Fun-14Bのビデオ制御ウェイト。Canny、Depth、Pose、MLSDなどの異なる制御条件をサポートし、トラジェクトリ制御も利用可能。512、768、1024のマルチ解像度でのビデオ予測をサポートし、81フレーム(1秒間に16フレーム)でトレーニング済みで、多言語予測にも対応しています。 |
4. Wan2.1
| 名称 | Hugging Face | Model Scope | 説明 |
|---|---|---|---|
| Wan2.1-T2V-1.3B | 🤗Link | 😄Link | 万象2.1-1.3Bのテキストから動画生成する重み |
| Wan2.1-T2V-14B | 🤗Link | 😄Link | 万象2.1-14Bのテキストから動画生成する重み |
| Wan2.1-I2V-14B-480P | 🤗Link | 😄Link | 万象2.1-14B-480Pの画像から動画生成する重み |
| Wan2.1-I2V-14B-720P | 🤗Link | 😄Link | 万象2.1-14B-720Pの画像から動画生成する重み |
5. FantasyTalking
| 名称 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Wan2.1-I2V-14B-720P | - | 🤗Link | 😄Link | 万象2.1-14B-720P 画像→動画モデルの重み |
| Wav2Vec | - | 🤗Link | 😄Link | Wav2Vecモデル。Wan2.1-I2V-14B-720Pフォルダ内に配置し、audio_encoder という名前に変更してください |
| FantasyTalking model | - | 🤗Link | 😄Link | 公式Audio Condition重み |
6. Qwen-Image
| 名称 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Qwen-Image | 🤗Link | 😄Link | Qwen-Image 公式重み | |
| Qwen-Image-Edit | 🤗Link | 😄Link | Qwen-Image-Edit 公式重み | |
| Qwen-Image-Edit-2509 | 🤗Link | 😄Link | Qwen-Image-Edit-2509 公式重み |
7. Qwen-Image-Fun
| 名前 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Qwen-Image-2512-Fun-Controlnet-Union | - | 🤗リンク | 😄リンク | Qwen-Image-2512のControlNet重み。Canny、Depth、Pose、MLSD、Scribbleなど、複数の制御条件をサポートします。 |
8. Z-Image
| 名称 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Z-Image | 🤗リンク | 😄リンク | Z-Imageの公式重み | |
| Z-Image-Turbo | 🤗リンク | 😄リンク | Z-Image-Turboの公式重み |
9. Z-Image-Fun
| 名称 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| Z-Image-Fun-Controlnet-Union-2.1 | - | 🤗Link | 😄Link | Z-ImageのControlNet重み、Canny、Depth、Pose、MLSD、ScribbleおよびGrayなど複数の制御条件に対応。 |
| Z-Image-Fun-Lora-Distill | - | 🤗Link | 😄Link | これはZ-Image用の蒸留LoRAで、ステップ数とCFGの両方を蒸留します。このモデルはCFGを必要とせず、推論には8ステップを使用します。 |
| Z-Image-Turbo-Fun-Controlnet-Union | - | 🤗リンク | 😄リンク | Z-Image-Turbo用のControlNet重み。Canny、Depth、Pose、MLSDなど複数の制御条件をサポート。 |
| Z-Image-Turbo-Fun-Controlnet-Union-2.1 | - | 🤗リンク | 😄リンク | Z-Image-TurboのControlNet重み。第1版と比較して、より多くの層に追加され、より長時間トレーニングされています。Canny、Depth、Pose、MLSDなど、複数の制御条件をサポートしています。 |
10. Flux
| 名称 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| FLUX.1-dev | 🤗Link | 😄Link | FLUX.1-dev 公式重み | |
| FLUX.2-dev | 🤗Link | 😄Link | FLUX.2-dev 公式重み |
11. Flux-Fun
| 名前 | ストレージ | Hugging Face | ModelScope | 説明 |
|---|---|---|---|---|
| Flux.2-dev-Fun-Controlnet-Union | - | 🤗リンク | 😄リンク | Flux.2-dev 用の ControlNet 重みで、Canny、Depth、Pose、MLSD など様々な制御条件をサポートします。 |
12. HunyuanVideo
| 名称 | ストレージ | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| HunyuanVideo | 🤗Link | - | HunyuanVideo-diffusers 公式重み | |
| HunyuanVideo-I2V | 🤗Link | - | HunyuanVideo-I2V-diffusers 公式重み |
13. CogVideoX-Fun
V1.5:
| 名称 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| CogVideoX-Fun-V1.5-5b-InP | 20.0 GB | 🤗Link | 😄Link | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024)でビデオを予測できます。85フレーム、8フレーム/秒でトレーニングされています。 |
| CogVideoX-Fun-V1.5-Reward-LoRAs | - | 🤗リンク | 😄リンク | 公式の報酬逆伝播技術モデルで、CogVideoX-Fun-V1.5が生成するビデオを最適化し、人間の嗜好によりよく合うようにする。 |
V1.1:
| 名称 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| CogVideoX-Fun-V1.1-2b-InP | 13.0 GB | 🤗リンク | 😄リンク | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。参照画像にノイズが追加され、V1.0と比較して動きの幅が広がっています。 |
| CogVideoX-Fun-V1.1-5b-InP | 20.0 GB | 🤗リンク | 😄リンク | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。参照画像にノイズが追加され、V1.0と比較して動きの幅が広がっています。 |
| CogVideoX-Fun-V1.1-2b-Pose | 13.0 GB | 🤗リンク | 😄リンク | 公式のポーズコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。 |
| CogVideoX-Fun-V1.1-2b-Control | 13.0 GB | 🤗Link | 😄Link | 公式のコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。Canny、Depth、Pose、MLSDなどのさまざまなコントロール条件をサポートします。 |
| CogVideoX-Fun-V1.1-5b-Pose | 20.0 GB | 🤗リンク | 😄リンク | 公式のポーズコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。 |
| CogVideoX-Fun-V1.1-5b-Control | 20.0 GB | 🤗リンク | 😄リンク | 公式のコントロールビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。Canny、Depth、Pose、MLSDなどのさまざまなコントロール条件をサポートします。 |
| CogVideoX-Fun-V1.1-Reward-LoRAs | - | 🤗リンク | 😄リンク | 公式の報酬逆伝播技術モデルで、CogVideoX-Fun-V1.1が生成するビデオを最適化し、人間の嗜好によりよく合うようにする。 |
(Obsolete) V1.0:
| 名称 | ストレージスペース | Hugging Face | Model Scope | 説明 |
|---|---|---|---|---|
| CogVideoX-Fun-2b-InP | 13.0 GB | 🤗リンク | 😄リンク | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。 |
| CogVideoX-Fun-5b-InP | 20.0 GB | 🤗リンク | 😄リンク | 公式のグラフ生成ビデオモデルは、複数の解像度(512、768、1024、1280)でビデオを予測できます。49フレーム、8フレーム/秒でトレーニングされています。 |
参考文献
- CogVideo: https://github.com/THUDM/CogVideo/
- EasyAnimate: https://github.com/aigc-apps/EasyAnimate
- Wan2.1: https://github.com/Wan-Video/Wan2.1/
- Wan2.2: https://github.com/Wan-Video/Wan2.2/
- Diffusers: https://github.com/huggingface/diffusers
- Qwen-Image: https://github.com/QwenLM/Qwen-Image
- Self-Forcing: https://github.com/guandeh17/Self-Forcing
- Flux: https://github.com/black-forest-labs/flux
- Flux2: https://github.com/black-forest-labs/flux2
- HunyuanVideo: https://github.com/Tencent-Hunyuan/HunyuanVideo
- ComfyUI-KJNodes: https://github.com/kijai/ComfyUI-KJNodes
- ComfyUI-EasyAnimateWrapper: https://github.com/kijai/ComfyUI-EasyAnimateWrapper
- ComfyUI-CameraCtrl-Wrapper: https://github.com/chaojie/ComfyUI-CameraCtrl-Wrapper
- CameraCtrl: https://github.com/hehao13/CameraCtrl
引用
研究やプロジェクトでVideoX-Funを使用する場合は、以下の形式で引用してください:
@misc{aigc_apps_VideoX_Fun_2026,
  author = {aigc-apps},
  title = {VideoX-Fun: A Video Generation Pipeline for Diffusion Transformer},
  year = {2026},
  publisher = {GitHub},
  url = {https://github.com/aigc-apps/VideoX-Fun}
}
制限とリスク
- 生成された動画には、特に複雑なシーンでアーティファクトや品質の問題がある場合があります。
- モデルは、細かい詳細、テキストのレンダリング、または特定の芸術スタイルで苦労する場合があります。
- パフォーマンスは、入力プロンプトの品質、解像度、その他のパラメータによって異なります。
- この技術は、誤解を招くコンテンツ(例:ディープフェイク)を作成するために悪用される可能性があります。ユーザーは倫理的な使用に責任を持ちます。
- モデルは、トレーニングデータに存在するバイアスを反映する可能性があります。
- ユーザーは、実在の人物の画像や動画を使用する際、プライバシーと著作権を尊重する必要があります。
責任ある使用を推奨し、本番環境でのセーフガードの実装をお勧めします。
ライセンス
このプロジェクトはApache License (Version 2.0)の下でライセンスされています。
CogVideoX-2Bモデル(対応するTransformersモジュール、VAEモジュールを含む)は、Apache 2.0ライセンスの下でリリースされています。
CogVideoX-5Bモデル(Transformersモジュール)は、CogVideoXライセンスの下でリリースされています。